








排查负载均衡健康检查的核心在于确认后端服务的实际响应状态与负载均衡器的判定逻辑是否一致,通常通过直接访问后端端口、检查负载均衡器配置以及分析日志来定位问题。具体做法包括验证后端服务是否监听正确端口并返回http 200或指定状态码,检查健康检查的路径、协议和超时设置是否与业务需求匹配,同时查看负载均衡器和后端实例的日志以捕捉连接拒绝或超时错误。
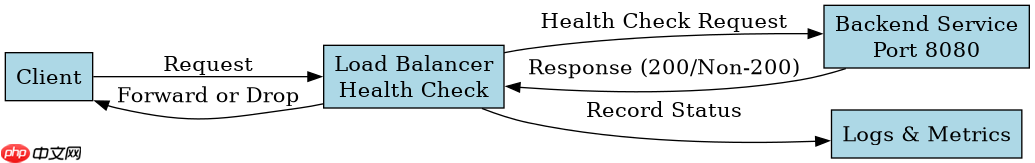
如何验证后端服务是否真正响应健康检查请求
要验证后端服务是否响应,最直接的方法是绕过负载均衡器,使用curl命令直接请求后端实例的健康检查端点。如果直接请求失败,说明是应用层或服务配置问题;如果直接请求成功但负载均衡器仍标记为不健康,则问题出在负载均衡器的配置或网络连通性上。例如,对于运行在8080端口的Web服务,可以执行curl -v http://<backend_ip>:8080/health</backend_ip>来观察返回的状态码和响应体。
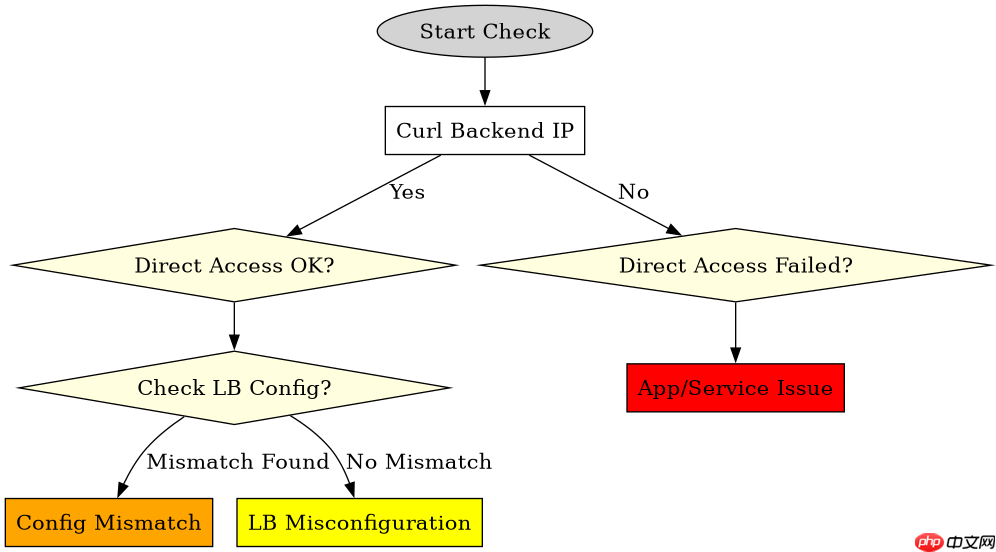
import requests

def check_backend_health(backend_ip, port, path):
    url = f"http://{backend_ip}:{port}{path}"
    try:
        response = requests.get(url, timeout=5)
        if response.status_code == 200:
            print(f"Backend {backend_ip} is healthy.")
        else:
            print(f"Backend {backend_ip} returned status {response.status_code}.")
    except requests.exceptions.RequestException as e:
        print(f"Failed to connect to {backend_ip}: {e}")

# 示例调用
check_backend_health("192.168.1.10", 8080, "/health")
负载均衡器健康检查配置常见错误有哪些
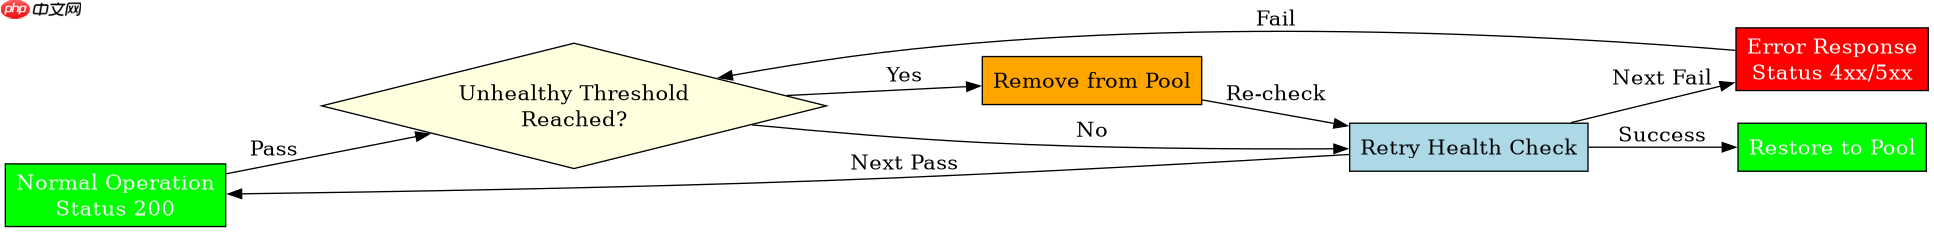
常见的配置错误包括健康检查路径不存在、超时时间过短导致误判、以及协议不匹配。例如,如果后端服务需要特定的Header才能返回200,而负载均衡器未发送该Header,会导致持续的不健康状态。此外,如果健康检查的频率过高或间隔过短,可能会增加后端负载,导致服务暂时不可用从而触发不健康标记。检查配置时,应确保healthy_threshold和unhealthy_threshold的设置合理,避免因短暂的网络抖动导致实例被频繁剔除。
# Nginx upstream health check configuration example
upstream backend {
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;
    # 假设使用nginx-upstream-health-module
    health_check interval=30 fails=3 passes=2 uri=/health;
}
当后端服务返回非200状态码时负载均衡器如何处理
当后端服务返回非200状态码(如404或500)时,负载均衡器会根据配置的unhealthy_threshold将实例标记为不健康。一旦实例被标记为不健康,负载均衡器会停止向该实例转发流量,直到其再次通过健康检查。这一机制确保了只有正常工作的服务才能接收用户请求。例如,如果后端服务在维护期间返回503,负载均衡器会在连续多次检查失败后将其从池中移除,避免用户访问到错误页面。






















