








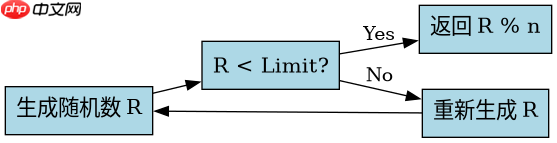
使用取余运算确实会引入偏差,正确做法是拒绝采样。具体而言,先计算一个小于等于最大整数的、能被目标范围大小整除的最大值作为上限,当生成的随机数超过这个上限时直接丢弃并重新生成,直到落在有效范围内为止。这样能保证每个结果出现的概率严格相等。
为什么取余会产生偏差
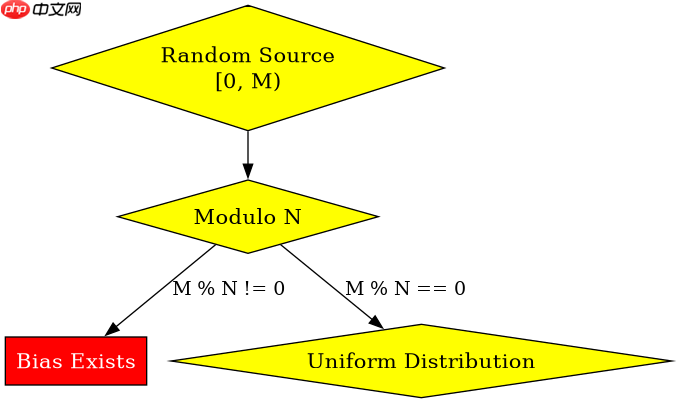
假设我们需要生成 0 到 n-1 之间的随机整数,而底层随机源产生的是 0 到 m-1 的均匀分布。如果 m 不能被 n 整除,那么对 m 取余后,某些数字会比其他数字多出现一次。例如,若 m=5, n=3,则 0%3=0, 1%3=1, 2%3=2, 3%3=0, 4%3=1。可以看到 0 和 1 出现了两次,而 2 只出现了一次,导致分布不均。
import random

def biased_rand(n):
    return random.randint(0, 9) % n

def correct_rand(n):
    max_val = (random.getrandbits(32) // n) * n
    while True:
        r = random.getrandbits(32)
        if r < max_val:
            return r % n

# 测试示例
print(biased_rand(3))
print(correct_rand(3))
如何确定拒绝采样的上限
为了消除偏差,我们需要找到一个最大的阈值 limit,使得 [0, limit) 区间内的所有整数在取模 n 后能均匀分布。这个 limit 必须是 n 的倍数,且不能超过随机源的最大值。通常的做法是利用位运算或除法找到最接近随机源最大值且为 n 倍数的数。任何大于等于 limit 的随机数都被视为无效,需要重新生成。
def get_limit(max_random, n):
    # 计算不超过 max_random 的最大的 n 的倍数
    return (max_random // n) * n

# 验证逻辑
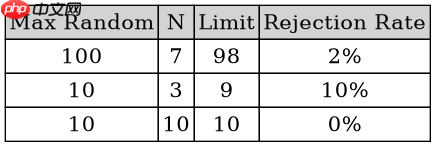
limit = get_limit(100, 7)
print(f"Limit: {limit}") # 输出 98
# 0-97 共 98 个数,98/7=14,每个余数出现 14 次
# 98-99 被拒绝
基于程序中某个输入、条件或结果的具体问题
当随机源的最大值非常接近 n 的倍数时,拒绝率会很低,效率最高。但如果随机源的范围很小,比如只有 10 个值,而我们要生成 0-9 的随机数,此时 10 能被 10 整除,无需拒绝。如果我们要生成 0-6 的随机数,10 不能被 7 整除,limit 为 7,拒绝率为 3/10。在实际编程中,应确保随机源的范围足够大,以减少重试次数。






















