








使用 fetch api 处理接口返回的压缩数据时,核心做法是依赖浏览器自动解压缩。当服务器响应头中包含 content-encoding: gzip、deflate 或 br 时,fetch 会在底层自动调用系统库进行解压,开发者无需手动编写解压逻辑。只需正常调用 fetch() 并读取 response 对象即可,若需验证或处理非标准编码,可借助 decompressionstream api 进行流式解压。
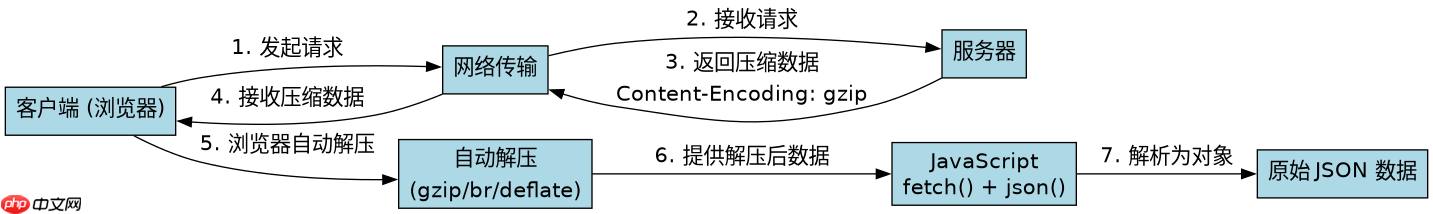
Fetch 默认如何处理 Content-Encoding 头部
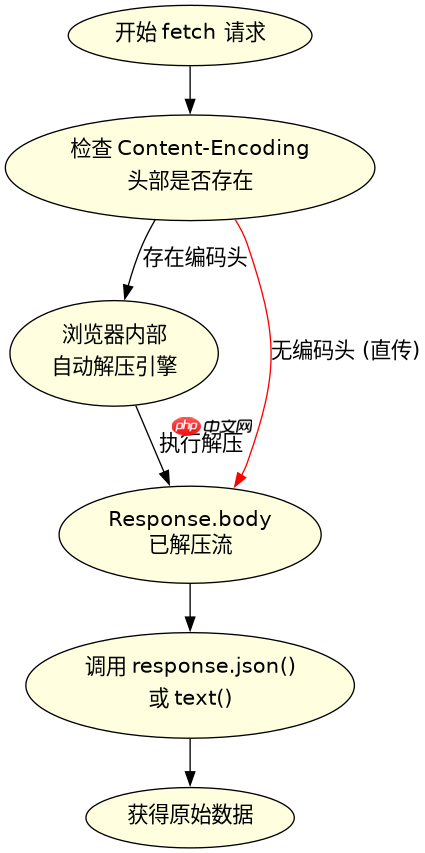
Fetch API 在接收到带有 Content-Encoding 头的响应时,会自动识别并解压数据。这意味着对于常见的 gzip 和 br 格式,你直接获取到的 Response 对象中的文本或二进制内容已经是解压后的原始数据。这一过程对 JavaScript 代码完全透明,不需要额外的配置或第三方库支持。
const url = 'https://api.example.com/data';

fetch(url)
  .then(response => {
    // 此时 response.body 已经是解压后的流
    // 如果服务器发送了 gzip 数据,浏览器已自动解压
    return response.json();
  })
  .then(data => {
    console.log('解压后的数据:', data);
  })
  .catch(error => {
    console.error('请求失败:', error);
  });
如何使用 DecompressionStream 处理特定编码
虽然大多数情况下浏览器自动处理足够,但在某些场景下(如需要处理 deflate 且浏览器行为不一致,或需要自定义解压流程),可以使用 Web Streams API 中的 DecompressionStream。它允许你在读取响应体之前插入一个转换步骤,将压缩流转换为未压缩流。这种方法提供了更细粒度的控制,适用于需要兼容旧环境或特殊编码的情况。

立即学习“Java免费学习笔记(深入)”;

async function fetchDecompressed(url, encodingType) {
  const response = await fetch(url);

  if (!response.ok) {
    throw new Error(`HTTP error! status: ${response.status}`);
  }

  // 创建解压流
  const decompressionStream = new DecompressionStream(encodingType);

  // 将响应体通过解压流
  const decompressedBody = response.body.pipeThrough(decompressionStream);

  // 创建新的 Response 对象
  const newResponse = new Response(decompressedBody, {
    status: response.status,
    statusText: response.statusText,
    headers: response.headers
  });

  // 移除 Content-Encoding 头,因为数据已解压
  newResponse.headers.delete('Content-Encoding');

  return newResponse.json();
}

// 使用示例:处理 gzip 压缩的数据
fetchDecompressed('https://api.example.com/gzip-data', 'gzip')
  .then(data => console.log('手动解压结果:', data));
DecompressionStream 支持的编码类型有哪些
DecompressionStream 构造函数接受一个字符串参数来指定压缩算法,目前主要支持 "gzip"、"deflate" 和 "br"(Brotli)。这些编码类型与 HTTP 响应头中的 Content-Encoding 值对应。需要注意的是,deflate 在某些浏览器中可能表现不一致,而 gzip 和 br 得到广泛支持。如果传入不支持的编码类型,会抛出 TypeError。在实际开发中,建议先检查浏览器兼容性,或在服务端优先使用 gzip 以确保最大兼容性。


















