








使用 promise.all 并行发起多个分页请求,并将结果数组拼接即可实现数据合并。具体做法是定义一个包含页码、url 和查询参数的配置列表,通过循环或映射生成对应的 promise 对象,最后等待所有请求完成并展开结果。若需处理大量数据导致内存溢出,应改用异步迭代器逐个处理响应,避免一次性加载全部数据。

如何并行获取多页数据并合并为单一数组
并行获取多页数据的核心在于利用 Promise.all 同时发起网络请求。假设我们需要从 API 获取前 3 页数据,每页 10 条记录,我们可以构建一个包含页码的数组,将其映射为 fetch 调用,最后将返回的数据扁平化。这种方法能显著减少总等待时间,因为各页请求互不阻塞。
const pages = [1, 2, 3];
const baseUrl = 'https://api.example.com/items';

async function fetchAllData() {
  const requests = pages.map(page =>
    fetch(`${baseUrl}?page=${page}&limit=10`).then(res => res.json())
  );

  const results = await Promise.all(requests);
  // 假设 API 返回 { data: [...] }
  return results.flatMap(res => res.data);
}

fetchAllData().then(data => console.log('Merged:', data.length));
运行上述代码,控制台将输出合并后的数据数组长度,例如 30。每个 Promise 独立执行,最终由 Promise.all 收集所有成功响应。如果任一请求失败,整个操作将抛出异常,因此实际生产中建议结合 Promise.allSettled 进行错误隔离。
立即学习“Java免费学习笔记(深入)”;

如何处理单页请求中的游标分页(Cursor)
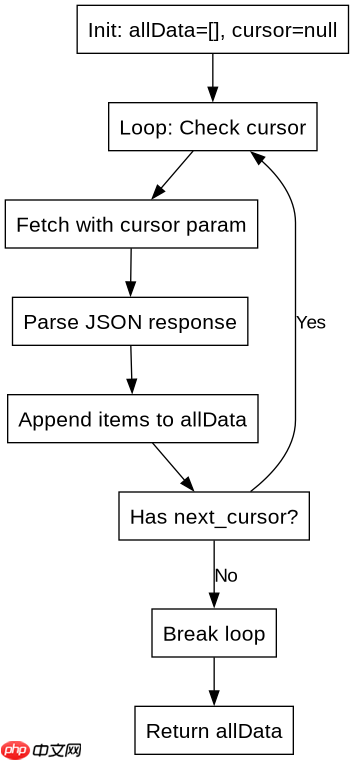
当 API 使用游标而非页码时,无法预先知道总页数,必须根据上一页的响应决定下一页是否存在。此时应采用递归或循环结构,持续请求直到没有更多数据。关键在于解析响应头或响应体中的 next_cursor 字段,判断是否继续追加请求。
async function fetchWithCursor(url) {
  let allData = [];
  let cursor = null;

  while (true) {
    const params = new URLSearchParams({ limit: 10 });
    if (cursor) params.set('cursor', cursor);

    const res = await fetch(`${url}?${params}`);
    const json = await res.json();

    allData = allData.concat(json.items);

    if (!json.next_cursor) break; // 无更多数据则退出
    cursor = json.next_cursor;
  }

  return allData;
}

fetchWithCursor('https://api.example.com/items').then(console.log);)
该函数会持续累加数据,直到 next_cursor 为空。每次循环仅保留当前批次数据与累积结果,内存占用稳定。若 API 返回结构不同,需调整 json.items 的访问路径。此模式适用于无限滚动或大数据集导出场景。
当某页请求失败时,程序如何保证其他页数据不被丢弃
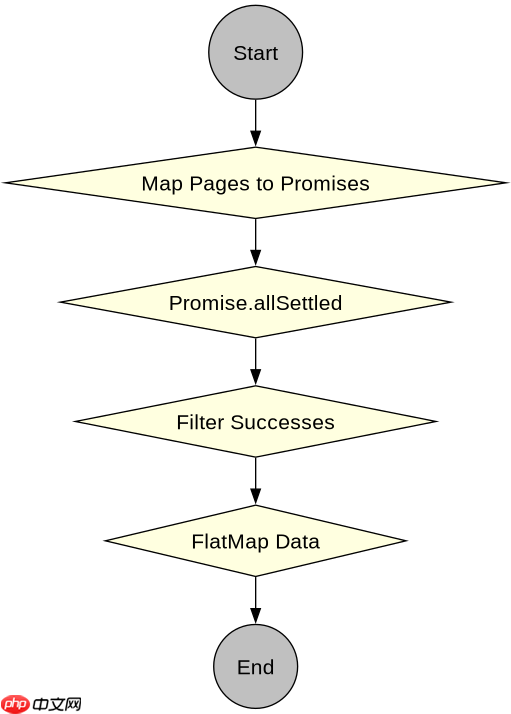
在并行请求中,若某一页失败,Promise.all 会立即拒绝并丢弃所有已成功的结果。为避免此问题,应将单个请求包裹在 try...catch 或使用 Promise.allSettled。后者返回每个请求的状态,允许我们过滤出成功的响应并合并其数据,忽略失败的页面。
async function fetchRobustly(pages) {
  const requests = pages.map(page =>
    fetch(`https://api.example.com/items?page=${page}`).then(r => r.json()).catch(() => null)
  );

  const results = await Promise.all(requests);
  return results.filter(Boolean).flatMap(res => res.data);
}
使用 catch(() => null) 确保单个请求失败不会中断整体流程。最终结果仅包含成功页面的数据,缺失页以静默方式跳过。这种策略在弱网环境下尤为实用,能保证尽可能多地获取有效数据。


















