








使用 fetch 获取 amr 数据时,必须将响应类型设置为 arraybuffer,因为 amr 是二进制格式。调用 response.arraybuffer() 方法即可拿到原始字节流,随后通过 uint8array 进行后续处理或转换。

如何验证获取到的 AMR 文件头是否有效
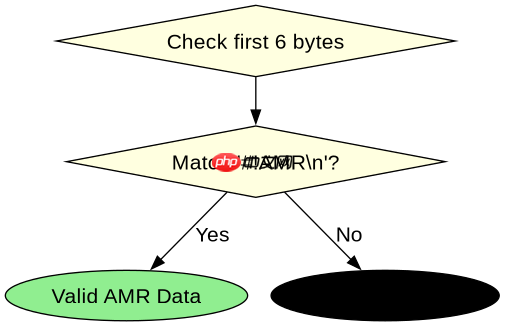
AMR 文件的开头包含特定的魔法数字,用于标识文件格式。在 JavaScript 中,可以通过检查 arrayBuffer 的前几个字节来验证数据完整性。标准的 AMR-NB 文件头以 #!AMR\n 开头,对应的 ASCII 码为 0x23, 0x21, 0x41, 0x4D, 0x52, 0x0A。如果前六个字节匹配这些值,说明获取到了正确的 AMR 数据;否则可能是网络错误、非 AMR 内容或损坏的文件。
// 假设 response 是 fetch 返回的 Response 对象
async function validateAmrHeader(arrayBuffer) {
  const view = new Uint8Array(arrayBuffer);
  // #!AMR\n 的十六进制表示
  const expectedHeader = [0x23, 0x21, 0x41, 0x4D, 0x52, 0x0A];

  for (let i = 0; i < expectedHeader.length; i++) {
    if (view[i] !== expectedHeader[i]) {
      return false;
    }
  }
  return true;
}

// 使用示例
const buffer = await response.arrayBuffer();
if (await validateAmrHeader(buffer)) {
  console.log("有效的 AMR 数据");
} else {
  console.error("无效的 AMR 数据");
}
上述代码展示了如何逐字节比对文件头。在实际应用中,建议先执行此验证步骤,确保后续解码逻辑不会因数据格式错误而崩溃。若验证失败,应检查请求 URL 是否正确指向了音频接口,以及服务器是否返回了预期的二进制流而非 JSON 或 HTML 错误页。
立即学习“Java免费学习笔记(深入)”;
如何将 AMR 二进制数据转换为 Base64 字符串
在许多前端场景中,需要将二进制音频数据嵌入到 JSON 响应中或通过 WebSocket 传输,此时 Base64 编码是常见选择。JavaScript 中没有内置的直接转换函数,但可以通过 Array.prototype.map 结合 String.fromCharCode 将 Uint8Array 转换为字符串,再使用 btoa 进行编码。需要注意的是,对于较大的 AMR 文件(通常几 KB 到几十 KB),这种转换可能会产生性能开销,但对于短语音片段完全可行。


function arrayBufferToBase64(buffer) {
  const bytes = new Uint8Array(buffer);
  let binary = '';
  for (let i = 0; i < bytes.byteLength; i++) {
    binary += String.fromCharCode(bytes[i]);
  }
  return btoa(binary);
}

// 使用示例
const base64Amr = arrayBufferToBase64(buffer);
console.log(base64Amr.substring(0, 20) + '...'); // 输出前20个字符
该函数遍历每个字节并将其转换为对应的字符,最后由 btoa 完成编码。生成的 Base64 字符串可以直接赋值给 HTML 元素或作为 API 参数发送。如果需要解码回二进制,可使用 atob 并反向操作。此方法适用于需要跨平台共享 AMR 数据的场景,例如存储在 IndexedDB 或发送到后端进行转码。
当 AMR 数据中包含扩展头(Extension Header)时如何处理
AMR 标准允许在帧之间插入扩展头,用于携带额外信息如时间戳或控制信号。在解析二进制流时,如果遇到字节值为 0x2C(即十进制 44),这通常标志着一个扩展头的开始。扩展头长度为 1 字节,紧随其后的是扩展数据。在处理循环中,遇到 0x2C 时应跳过该字节及随后的扩展数据字节,避免将其误认为普通语音帧。标准的 AMR-NB 帧长固定,但扩展头的存在使得简单按长度切分的方法不可靠,必须动态识别。
以下代码演示了如何在解析过程中跳过扩展头:
function parseAmrFrames(arrayBuffer) {
  const bytes = new Uint8Array(arrayBuffer);
  const frames = [];
  let index = 6; // 跳过文件头

  while (index < bytes.length) {
    // 检查是否为扩展头
    if (bytes[index] === 0x2C) {
      index += 2; // 跳过扩展头标记和扩展数据
      continue;
    }

    // 这里可以添加帧解析逻辑
    // 假设每帧固定长度,实际需根据模式位判断
    const frameEnd = index + getFrameLength(bytes[index]);
    if (frameEnd >= bytes.length) break;

    frames.push(bytes.slice(index, frameEnd));
    index = frameEnd;
  }
  return frames;
}

function getFrameLength(modeByte) {
  // 简化示例:不同模式对应不同帧长
  const lengths = [12, 13, 15, 17, 19, 20, 26, 31, 5, 0.5, 5.9, 0.6, 0.8, 0.5];
  const modeIndex = (modeByte >> 3) & 0x07;
  return Math.ceil(lengths[modeIndex] * 1.375); // AMR 帧长计算近似值
}
此解析器首先跳过文件头,然后逐个检查字节。若发现 0x2C,则跳过两个字节(标记和数据)。对于正常帧,根据模式位计算长度并提取。这种方法确保了扩展头不会干扰帧边界的识别。在实际项目中,建议使用成熟的 AMR 解码库来处理复杂的帧结构和模式切换,手动解析仅适用于轻量级需求或学习目的。


















