








charAt() 和 charCodeAt() 的核心区别是什么
charat() 返回指定索引处的字符(字符串),而 charcodeat() 返回该字符的 utf-16 编码单元值(数字)。前者用于获取可视文本,后者用于获取底层数值以便进行大小写转换或比较。若索引越界,charat() 返回空字符串,charcodeat() 返回 nan。
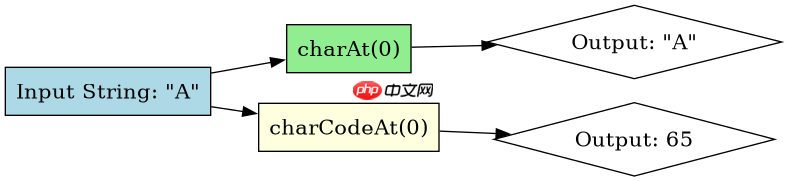
const str = 'A';
console.log(charAt(str, 0));       // "A"
console.log(charCodeAt(str, 0));   // 65
console.log(charAt(str, 1));       // ""
console.log(charCodeAt(str, 1));   // NaN
上述代码展示了基本用法。对于 ASCII 字符,charCodeAt 返回其对应的 Unicode 码点。注意 charCodeAt 仅处理 BMP 内的字符,对于超出 BMP 的字符(如 Emoji),它只返回第一个代理项的值,而非完整码点。
如何处理非 BMP 字符(如 Emoji)的差异
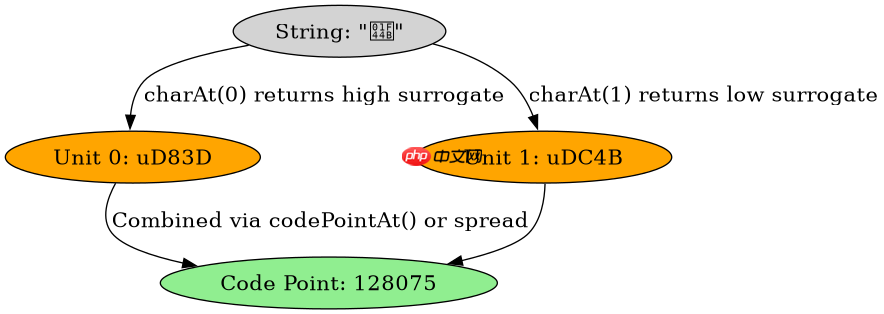
当处理包含 Emoji 等辅助平面字符的字符串时,charAt() 和 charCodeAt() 的行为与预期不同。它们基于 UTF-16 代码单元操作,而不是完整的 Unicode 码点。这意味着一个 Emoji 会被拆分为两个代码单元,导致索引错位。

立即学习“Java免费学习笔记(深入)”;
const emojiStr = '?';
console.log(emojiStr.length);          // 2
console.log(charAt(emojiStr, 0));      // "\uD83D" (高代理项)
console.log(charCodeAt(emojiStr, 0));  // 55357 (0xD83D)
console.log(charAt(emojiStr, 1));      // "\uDC4B" (低代理项)
console.log(charCodeAt(emojiStr, 1));  // 56491 (0xDC4B)
在上面的例子中,emojiStr.length 为 2,因为它是两个 UTF-16 代码单元。charAt(0) 只返回高代理项,这不是我们想要的完整 Emoji。要正确处理这种情况,应使用 codePointAt() 或展开运算符 [...]
基于输入长度和索引越界的边界条件问题
当输入的字符串为空或请求的索引超出范围时,两个方法都提供“安全”的默认行为,但类型不同。charAt() 始终返回字符串类型,即使越界也返回 ""。而 charCodeAt() 在越界时返回 NaN,这在数学运算中可能导致意外结果。
const emptyStr = '';
console.log(charAt(emptyStr, 0));      // ""
console.log(charCodeAt(emptyStr, 0));  // NaN

const shortStr = 'Hi';
console.log(charAt(shortStr, 5));      // ""
console.log(charCodeAt(shortStr, 5));  // NaN
这种差异在处理动态索引时很重要。如果后续逻辑期望数字结果,charCodeAt 返回的 NaN 会破坏计算;如果期望字符串拼接,charAt 的空字符串则更平滑。开发者应根据下游需求选择合适的方法,或在调用前检查索引有效性。


















