








取余结果出现负数时,业务层应通过添加模数再取余的方式将结果映射回非负区间。具体做法是在调用取余运算符后,判断结果是否小于零,若为负则加上除数(模数)再次取余或直接相加,从而确保返回值始终落在 [0, divisor) 范围内。这样做可以消除因被除数为负数导致的符号不一致问题,保证后续业务逻辑如数组索引或哈希桶分配的正确性。
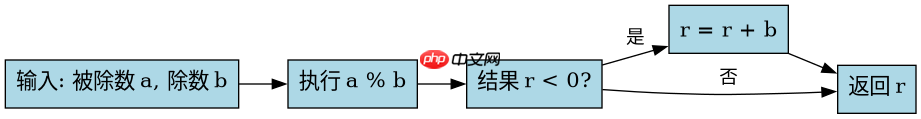
不同语言中取余运算的符号行为差异
在大多数编程语言中,取余运算 % 的符号取决于被除数的符号,这会导致负数输入时返回负值。例如在 Python 中 -7 % 3 结果为 2,而在 C++ 或 Java 中 -7 % 3 结果为 -1。这种差异源于语言对取余和取整的定义不同:Python 采用向下取整(floor division),而 C/Java 采用向零取整(truncation)。开发者在处理跨语言接口或混合环境时,必须明确当前语言的语义,避免直接假设取余结果为非负。
def safe_mod_python(a, b):
    return a % b

def unsafe_mod_c_style(a, b):
    # 模拟 C/Java 行为
    result = a % b
    if (a ^ b) < 0 and result != 0:
        result += b
    return result

# 测试输入
print(safe_mod_python(-7, 3))  # 输出: 2
print(unsafe_mod_c_style(-7, 3)) # 输出: 2
上述代码展示了两种处理策略。Python 原生支持数学意义上的取余,负数输入自动返回正余数。而模拟 C/Java 风格的函数通过检查符号位并调整结果,强制返回非负值。在实际业务中,若依赖第三方库或跨语言通信,建议统一封装此类安全取余函数,避免在业务逻辑中散落符号判断代码。
基于数组索引场景的具体兜底方案
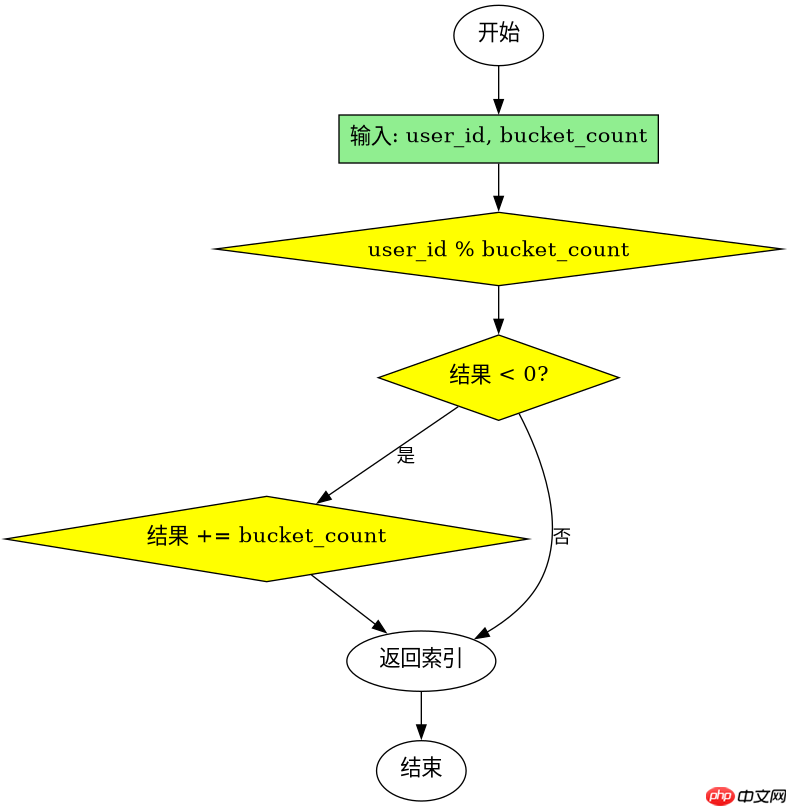
当取余结果用于数组索引时,负数会引发越界异常。此时需在计算索引前进行规范化处理。例如,若需将用户 ID 映射到大小为 N 的哈希表中,直接使用 user_id % N 在 user_id 为负时会抛出异常。正确的做法是先对 user_id 进行安全取余,确保结果在 [0, N) 之间,再作为索引访问数组。这一过程不改变哈希分布的均匀性,仅修正符号偏差。
def get_hash_bucket(user_id, bucket_count):
    # 安全取余:确保结果非负
    index = user_id % bucket_count
    if index < 0:
        index += bucket_count
    return index

# 测试
print(get_hash_bucket(-10, 5)) # 输出: 0
print(get_hash_bucket(10, 5))  # 输出: 0
print(get_hash_bucket(-1, 5))  # 输出: 4
该实现针对负数输入进行了显式修正。当 user_id 为 -10 且 bucket_count 为 5 时,C/Java 风格取余返回 0,无需调整;但当 user_id 为 -1 时,取余返回 -1,加 5 后变为 4,符合预期。此方法简单高效,适用于所有需要非负索引的场景。
基于程序中某个输入、条件或结果的具体问题
在程序中使用 get_hash_bucket(-1, 5) 时,若未进行负数修正,直接返回 -1 会导致数组越界。修正后返回 4,确保索引合法。这一结果验证了兜底逻辑的有效性:无论输入正负,最终索引均在有效范围内。开发者应在所有涉及取余的业务入口处应用此模式,以消除潜在运行时错误。


















