








通过开启sql日志监控或apm工具定位n+1查询,消除的核心是将循环中的单条查询替换为批量in查询。具体做法是在代码中收集循环内的id列表,调用一次带有where id in (...)条件的接口获取所有数据,并在内存中构建映射关系以组装最终结果。这样做可以将数据库交互次数从o(n)降低到o(1),显著减少网络开销和数据库负载。
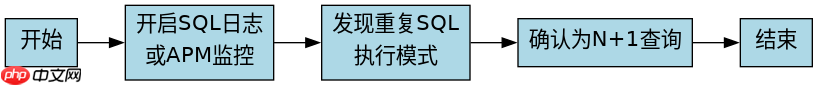
如何发现代码中的N+1查询问题
发现N+1查询最直接的方法是观察应用启动或运行时的数据库日志。当你在一个循环中反复执行相同的查询语句,且参数仅主键不同时,即为典型的N+1模式。例如,使用MyBatis时若未配置fetchType="lazy"或未使用@ManyToMany的批量加载策略,ORM框架默认会在每次迭代时发送一条SQL。通过查看日志中短时间内出现的重复SQL结构,即可快速锁定问题点。
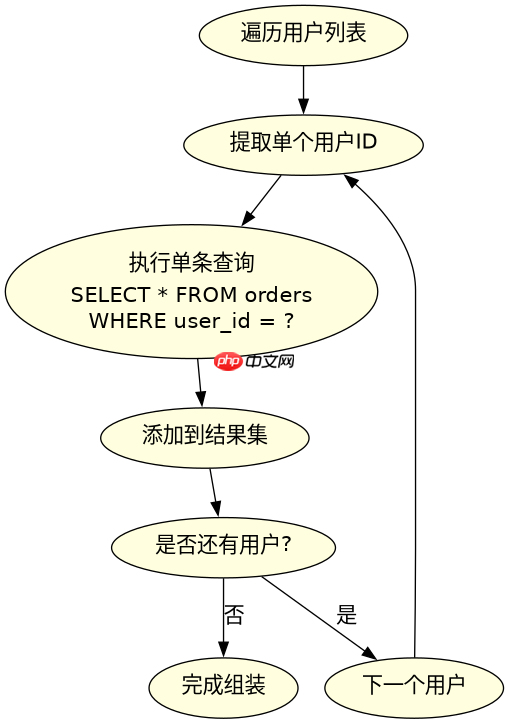
SELECT * FROM users WHERE id = 1;
SELECT * FROM orders WHERE user_id = 1;
SELECT * FROM orders WHERE user_id = 2;
SELECT * FROM orders WHERE user_id = 3;
上述日志显示,程序先查询了用户信息,随后在循环中为每个用户单独查询订单。这种模式在数据量稍大时会迅速拖慢系统响应。建议启用数据库的全局日志记录功能,或者使用如P6Spy、Druid等连接池监控插件,它们能自动统计SQL执行次数和执行时间,帮助识别异常高频的查询。
如何将循环查库重构为批量IN查询
消除N+1问题的标准重构步骤是提取ID集合、执行批量查询、内存组装。首先,遍历原始数据源,将所有需要关联查询的主键收集到一个List<long></long>中。接着,调用数据访问层的批量查询方法,传入该ID列表。最后,在Java内存中将查询结果转换为Map<long order></long>,以便后续通过ID快速查找对应数据,完成对象关系的组装。
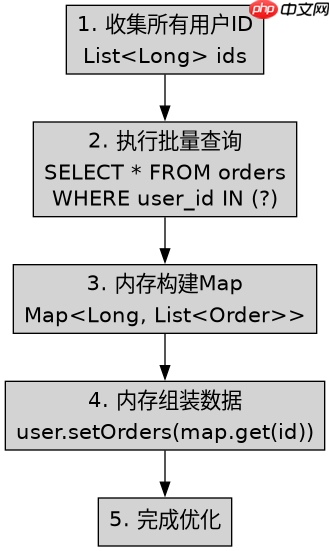
// 1. 收集ID
List<Long> userIds = users.stream()
    .map(User::getId)
    .collect(Collectors.toList());

// 2. 批量查询
List<Order> allOrders = orderMapper.selectByUserIds(userIds);

// 3. 内存组装
Map<Long, List<Order>> orderMap = allOrders.stream()
    .collect(Collectors.groupingBy(Order::getUserId));

users.forEach(user -> {
    user.setOrders(orderMap.getOrDefault(user.getId(), Collections.emptyList()));
});在实现批量查询时,需注意数据库对IN子句长度的限制。MySQL通常支持最多1000个值,若ID数量超过此阈值,应分批处理或使用临时表方案。此外,确保批量查询的SQL语句正确使用了IN关键字,并避免在IN列表中传入空值,否则可能导致查询结果为空或语法错误。
批量查询返回空列表时的处理逻辑
当批量查询的ID列表为空,或数据库中不存在对应的记录时,查询结果将返回空列表。此时,若在内存组装阶段直接使用get()方法而未做判空处理,可能会引发NullPointerException。正确的做法是使用getOrDefault()或显式检查列表是否为空,确保即使没有关联数据,业务对象也能保持正常的状态,不会因缺少关联数据而崩溃。

















