








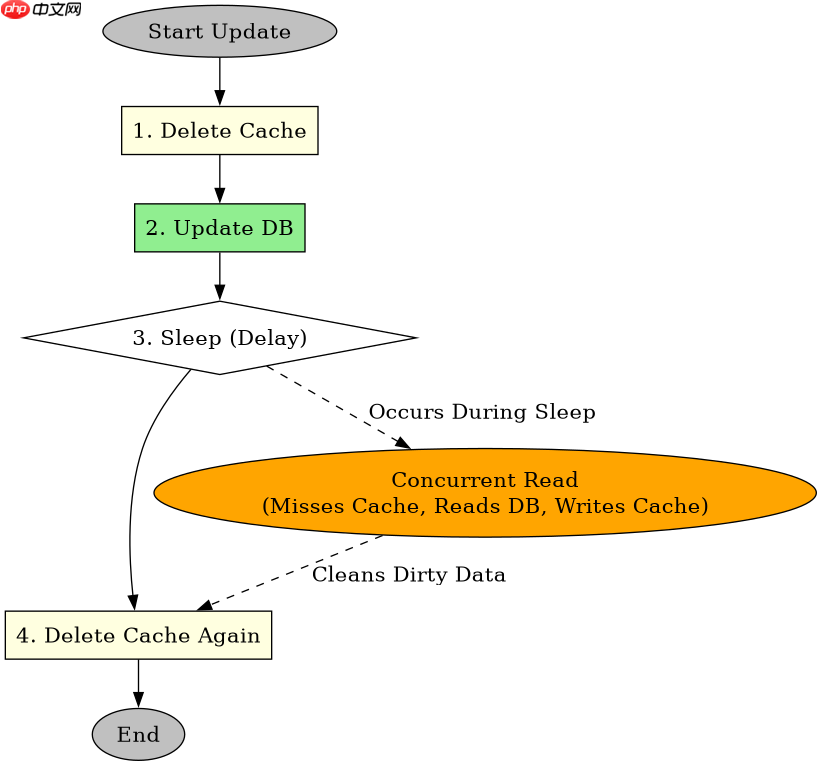
排查缓存和数据库双写不一致,核心在于确认写入路径是否覆盖了旧值以及删除时机是否正确;实现延迟双删则是通过先删缓存、更新数据库、再休眠片刻后二次删除缓存来清理脏数据。具体做法是确保业务逻辑中先执行 cache 删除或更新,再操作 db,并在异步线程中执行第二次删除以应对并发读请求。
如何定位双写不一致的具体原因
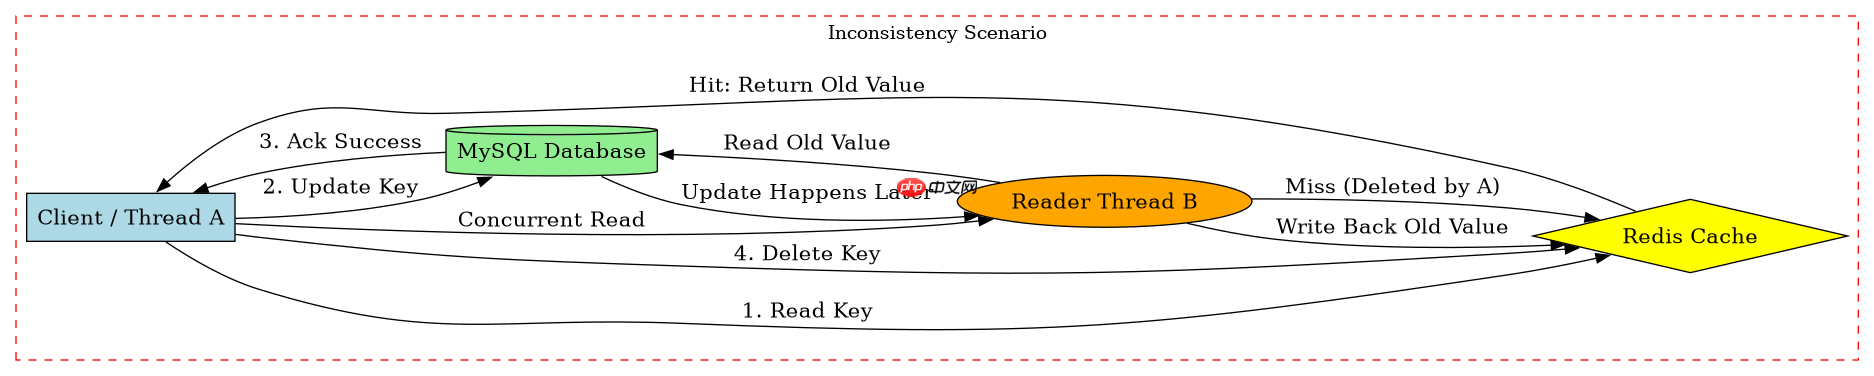
定位不一致通常从日志追踪和代码审查入手,重点检查是否存在只写缓存不写库、或者只写库不删缓存的分支。常见原因是高并发下读请求在写请求删除缓存后、更新DB前读取了旧值并回填了缓存,导致缓存与DB短暂不一致。

import time
import threading

class CacheDBSync:
    def __init__(self):
        self.cache = {}
        self.db = {}

    def get(self, key):
        # 1. 查缓存
        val = self.cache.get(key)
        if val is not None:
            return val

        # 2. 查数据库
        val = self.db.get(key)
        if val is not None:
            # 3. 回填缓存
            self.cache[key] = val
        return val

    def update(self, key, new_val):
        # 4. 先删缓存
        self.cache.pop(key, None)
        # 5. 再更数据库
        self.db[key] = new_val
        # 6. 延迟双删:再次尝试删除可能存在的脏缓存
        time.sleep(0.5) # 模拟延迟
        self.cache.pop(key, None)

# 测试场景
syncer = CacheDBSync()
syncer.update('user:1', 'v1')
print(syncer.get('user:1')) # 输出 v1
延迟双删的具体代码实现细节
延迟双删的实现关键在于“先删”、“更库”、“延时”、“再删”四个步骤的顺序不能乱。必须使用独立的线程或消息队列来执行第二次删除,避免阻塞主业务流程。休眠时间需略大于读请求的最大耗时,以确保在读请求完成前清除掉可能回填的旧值。

import time
import threading

def delayed_delete(cache_store, key, delay_seconds=0.5):
    """模拟异步延迟删除任务"""
    def task():
        time.sleep(delay_seconds)
        print(f"[Delayed Delete] Attempting to delete {key} from cache")
        cache_store.pop(key, None)

    thread = threading.Thread(target=task)
    thread.start()
    return thread

class RobustCacheManager:
    def __init__(self):
        self.cache = {}
        self.db = {}

    def write_with_delayed_double_delete(self, key, value):
        # Step 1: 删除旧缓存
        self.cache.pop(key, None)

        # Step 2: 更新数据库
        self.db[key] = value

        # Step 3: 启动延迟删除任务
        # 假设读请求最大耗时为 0.5s,这里设置稍长一点确保覆盖
        delayed_delete(self.cache, key, delay_seconds=0.6)

# 验证
mgr = RobustCacheManager()
mgr.write_with_delayed_double_delete('item:100', 'new_data')
time.sleep(0.7) # 等待延迟删除执行完毕
print(mgr.cache.get('item:100')) # 预期为 None,即使之前有并发读回填,此时也被清除
如果读请求在延迟期间完成了回填怎么办
如果读请求在第一次删除后、第二次删除前完成了“查库-写缓存”的操作,第二次删除会将其清除。但如果第二次删除失败(如网络抖动),或者读请求在第二次删除之后又发起了一次新的读,则可能再次出现不一致。解决此问题的终极方案是使用 Canal 监听 Binlog 异步同步缓存,或者使用 Redisson 分布式锁保证同一时刻只有一个线程进行 DB 更新和缓存维护。

















