





近日,openmoss(由复旦大学nlp实验室联合上海创智等团队共同发起)正式推出全新开源图像生成模型 —— moss-image。针对传统文生图模型在海报设计、信息图表、漫画创作及ui界面生成等场景中长期存在的“文字拼写错误、段落被意外截断、视觉元素位置偏移”等典型问题,该模型基于5b参数规模的单流 dit(diffusion transformer)架构,从零开始完成预训练,全面支持长达约4k token的提示词输入、中英文混合长文本渲染,以及可解析与编辑的结构化 json layout 输出。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
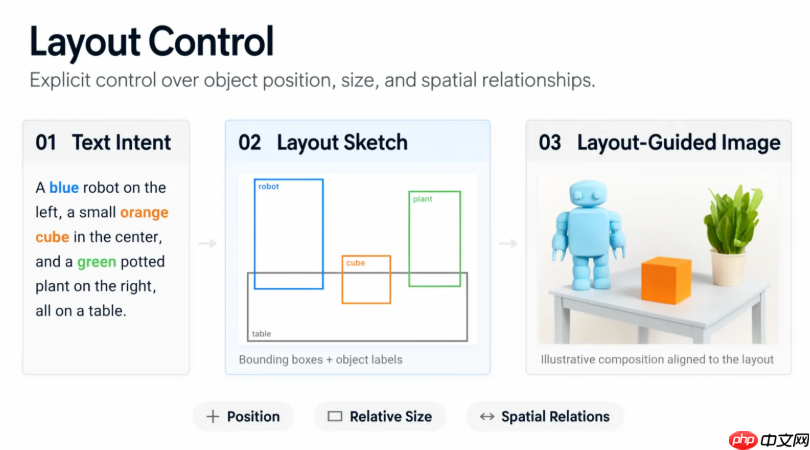
在技术实现层面,MOSS-Image采用 Muon–AdamW 优化策略,借助统一文本条件通道同步建模自然语言描述与结构化布局指令。其文本编码器选用 Qwen3.5-9B,图像解码则依托 FLUX.2VAE。训练数据覆盖约30亿张高质量图像,并融合多层级 caption 标注、细粒度文字监督信号及结构化边界框(bbox)监督信息。为更好响应复杂设计意图,模型额外集成一个意图感知型提示增强(Prompt Enhancement, PE)外部规划模块,可将用户简短指令自动转化为含字体层级、配色方案与像素级坐标规范的可执行生成指令。
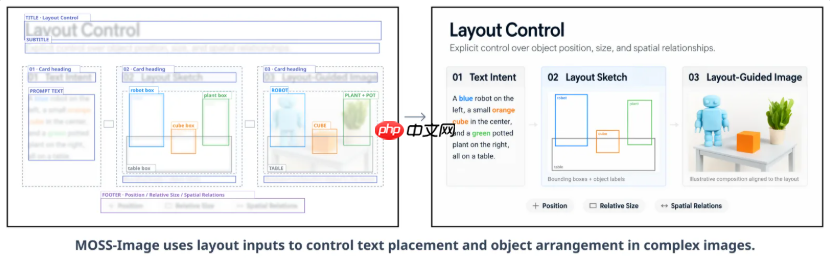
在关键能力验证与基准测试中,MOSS-Image展现出显著的垂直领域优势:

Qwen 视频智能分析基础客户端(免费版),基于 Qwen 3.5 Plus 多模态模型对本地视频进行内容分析,支持场景描述与基础内容理解,采用默认抽帧频率和提示词,适合快速概览视频,API Key 读取自 ~/.skill-platform/skill-platform.json 的 skills 配置。
长文本渲染能力(LLTB Benchmark):在涵盖中英文各120项任务、平均目标文本长度达1339.8字符的严苛评测中,其 Mean-6 指标得分高达96.3,刷新当前所有开源权重模型的最佳纪录,能精准维持换行逻辑与段落层次结构。
结构化布局精度(7Bench):在统一 JSON Layout 生成任务中,检测框 mIoU 达到0.8786,整体布局 mIoU 为0.6788,在空间关系建模与相对尺寸控制方面表现突出。
端到端用户体验(RealLayoutArena 盲测):在真实场景下的 Elo 排名中,该模型在统一增强提示词条件下的生成器得分达1807.34,位居行业前列。
目前,MOSS-Image 的 Base 版本与 SFT 微调权重均已基于 Apache-2.0 协议完全开源,并原生兼容 Diffusers、Gradio 和 ComfyUI 等主流生态工具链,支持 LoRA 高效微调与全参数微调。但官方也明确指出其当前能力边界:模型 backbone 为纯文本到图像生成范式,不支持参考图输入或原生图像编辑功能;其提示增强模块亦需依赖外部语言模型协同运行。总体而言,MOSS-Image 的发布,为追求本地化部署、高精度排版控制与可复现设计输出的开发者群体,提供了一个兼具先进性与实用性的开源新选项。













