








starlette 本身是异步框架,而 alembic 默认基于同步的 sqlalchemy 引擎运行,集成时需要解决异步与同步的兼容问题。核心做法是在 starlette 的 lifespan 事件或中间件中调用 alembic 的迁移脚本,并通过 run_async 模式或线程池处理数据库连接。具体实现通常涉及在应用启动时执行 upgrade 命令,确保数据库结构与应用代码一致。

Alembic 如何在 Starlette 生命周期中触发迁移
在 Starlette 应用中,最标准的集成方式是利用 lifespan 上下文管理器。当应用启动(startup)时,触发迁移逻辑;当应用关闭(shutdown)时,清理资源。由于 Alembic 的 command.upgrade() 是同步阻塞操作,直接放在异步 async def 中会阻塞事件循环。因此,需要将其包裹在 anyio.to_thread.run_sync 中执行,或者使用支持异步的 SQLAlchemy 2.0 风格连接。这里展示一种通用的、不依赖特定异步 ORM 版本的集成方案,即在启动阶段同步执行迁移。
import anyio
from starlette.applications import Starlette
from starlette.routing import Route
from alembic.config import Config
from alembic import command

def run_migrations():
    """同步执行 Alembic 迁移"""
    alembic_cfg = Config("alembic.ini")
    command.upgrade(alembic_cfg, "head")

async def startup_event():
    """应用启动时执行迁移"""
    # 将同步的 Alembic 调用放入线程池中运行
    await anyio.to_thread.run_sync(run_migrations)

async def shutdown_event():
    """应用关闭时的清理工作"""
    pass

app = Starlette(
    routes=[...],
    lifespan=lambda: {
        "startup": startup_event,
        "shutdown": shutdown_event
    }
)
上述代码展示了如何将 Alembic 集成到 Starlette 的生命周期中。关键点在于 anyio.to_thread.run_sync,它允许同步代码在不阻塞异步事件循环的情况下运行。配置对象 Config("alembic.ini") 指向标准的 Alembic 配置文件,command.upgrade 负责将数据库更新到最新版本。这种方式确保了每次应用重启时,数据库结构都是最新的。
如何处理异步数据库会话与 Alembic 的同步需求
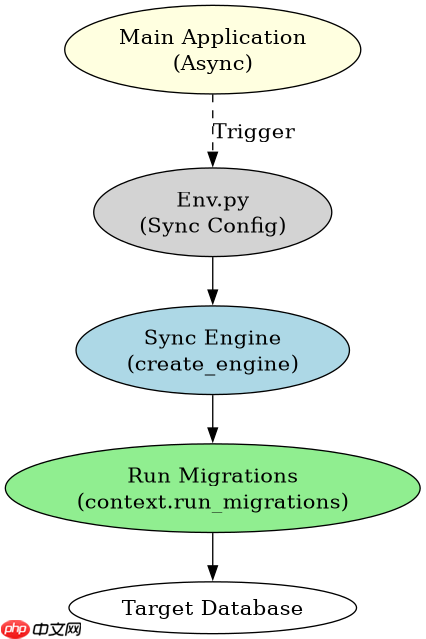
虽然迁移过程本身是同步的,但现代 Starlette 应用通常使用异步数据库客户端(如 databases 库或 SQLAlchemy 2.0 的异步引擎)。Alembic 的迁移脚本中可能需要执行一些自定义 SQL 或检查数据状态,这时需要处理同步与异步环境的切换。如果迁移脚本中需要访问数据库,必须确保使用的是同步连接。对于大多数情况,Alembic 的 env.py 文件中的 run_migrations_online 函数负责建立连接。如果项目使用 SQLAlchemy 2.0,可以在 env.py 中配置为使用同步引擎,即使主应用使用异步引擎。这样,迁移脚本可以正常执行,而不会影响主应用的异步性能。

Drizzle ORM 是一个轻量级的 TypeScript ORM,提供类型安全的 SQL 模式声明、关系型和类 SQL 查询构建器,以及自动生成迁移。其压缩后仅 7.4kb,且无依赖项,支持 PostgreSQL、MySQL 和 SQLite,包括 Neon、Turso 和 Cloudflare D1 等无服务器数据库。
# env.py 示例配置 (SQLAlchemy 2.0 风格)
from sqlalchemy import create_engine
from alembic import context

config = context.config

# 使用同步引擎进行迁移
engine = create_engine(config.get_main_option("sqlalchemy.url"))

def run_migrations_online():
    with engine.connect() as connection:
        context.configure(
            connection=connection,
            target_metadata=target_metadata
        )
        with context.begin_transaction():
            context.run_migrations()

if context.is_offline_mode():
    run_migrations_offline()
else:
    run_migrations_online()
这段代码展示了如何配置 Alembic 的 env.py 以使用同步引擎。通过 create_engine 创建同步连接,并在 run_migrations_online 中使用该连接执行迁移。这确保了迁移过程与主应用的异步环境解耦。开发者需要注意,如果迁移脚本中包含复杂的业务逻辑,应尽量避免在迁移脚本中编写复杂代码,保持迁移脚本的简洁性,仅用于数据结构变更。
迁移失败时如何回滚或调试
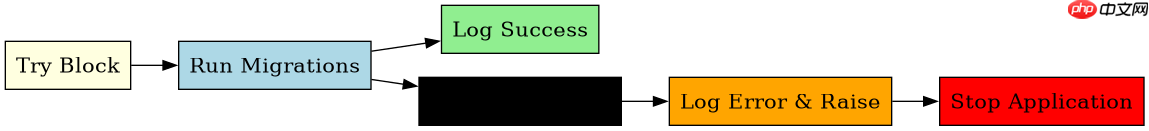
在实际开发中,迁移可能会因为约束冲突、数据类型不匹配等原因失败。Starlette 应用在启动时如果迁移失败,会导致应用无法启动。为了便于调试,可以在 startup_event 中添加异常捕获和日志记录。例如,使用 logging 模块记录详细的错误信息,帮助定位问题。此外,可以使用 Alembic 的 downgrade 命令来回滚到上一个版本,以便修复迁移脚本后重新执行。建议在开发环境中启用详细日志,以便观察迁移过程中的每一步操作。
import logging
import anyio
from starlette.applications import Starlette
from alembic.config import Config
from alembic import command

logger = logging.getLogger(__name__)

def run_migrations():
    alembic_cfg = Config("alembic.ini")
    try:
        command.upgrade(alembic_cfg, "head")
        logger.info("Migration completed successfully.")
    except Exception as e:
        logger.error(f"Migration failed: {e}")
        raise

async def startup_event():
    try:
        await anyio.to_thread.run_sync(run_migrations)
    except Exception as e:
        logger.critical(f"Application startup failed due to migration error: {e}")
        raise
此代码片段展示了如何在迁移过程中添加错误处理和日志记录。通过捕获异常并记录详细信息,开发者可以快速定位迁移失败的原因。如果迁移失败,应用将停止启动,防止在数据库结构不一致的情况下运行。这种机制提高了系统的健壮性,确保了数据库与应用代码的一致性。





















