








proxy_next_upstream 如何配置流式请求故障处理
在 nginx 中,通过 proxy_next_upstream 指令可以配置当后端服务器出现特定错误时自动切换到备用节点。对于流式请求(如 sse 或长连接),默认行为通常会在检测到连接断开后立即重试,这可能导致客户端收到重复数据。要精确控制这一行为,需要显式设置该指令的参数,并配合 proxy_buffering off 使用,以确保 nginx 不会缓冲数据而是直接透传,同时在发生上游故障时正确触发故障转移逻辑。
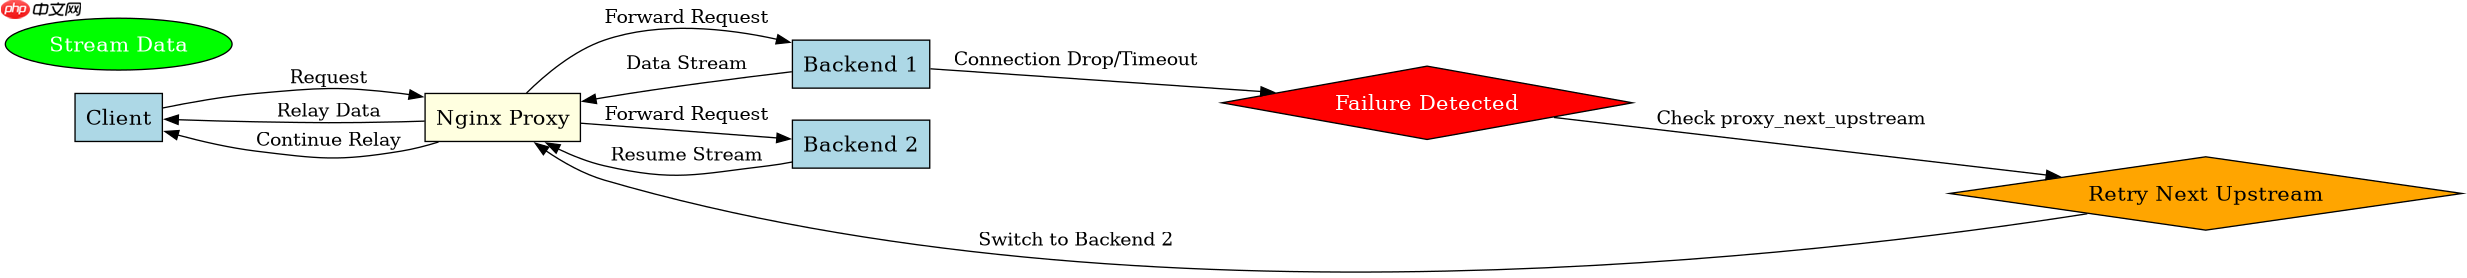
不同错误类型对故障转移的影响
Nginx 的故障转移机制依赖于具体的错误类型判断。常见的触发条件包括 error(通用错误)、timeout(超时)和 http_502(网关错误)。在处理流式数据时,如果上游服务器发送了部分数据后断开,Nginx 的行为取决于是否启用了缓冲以及具体的错误代码。例如,仅配置 http_502 可能无法捕获所有连接中断的情况,而 error 则更为宽泛。理解这些细微差别有助于避免不必要的重试或静默失败。
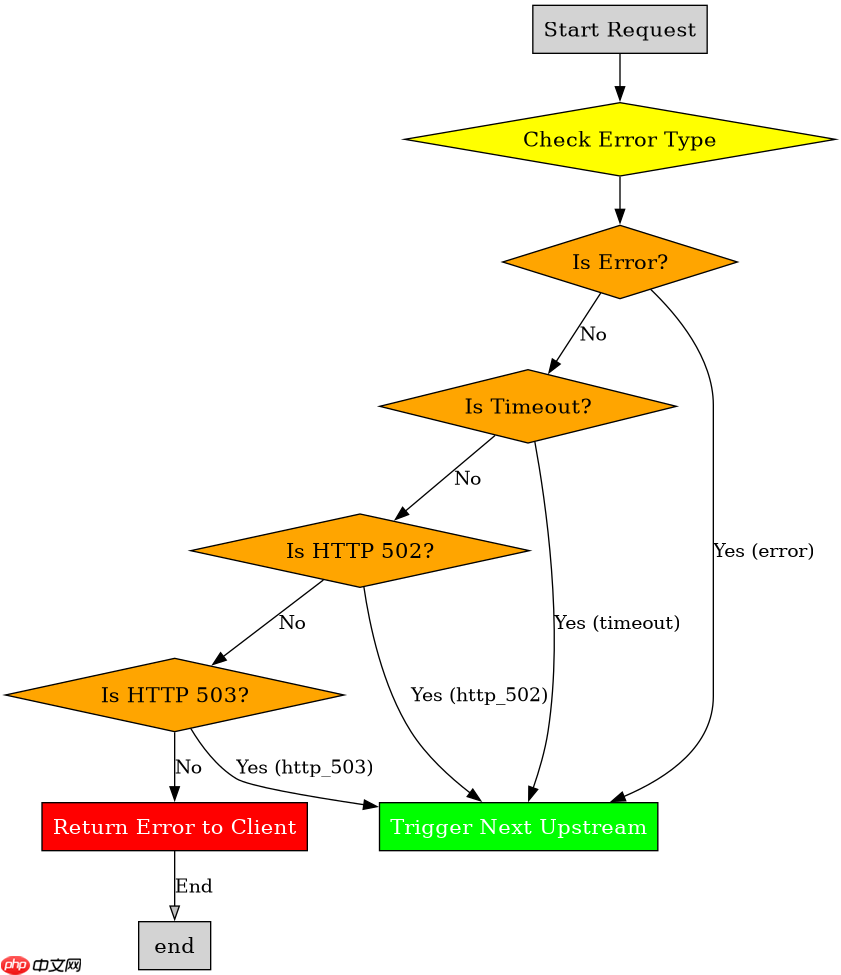

基于 proxy_next_upstream 中 timeout 参数的具体影响
当配置中包含 timeout 参数时,Nginx 会在等待上游响应超时时触发故障转移。对于流式请求,这意味着如果上游在指定时间内没有发送任何数据块,Nginx 将认为连接失效并尝试下一个节点。这种机制可以有效防止客户端长时间挂起,但也可能导致在正常慢速数据传输时被误判为故障。因此,合理设置超时时间并与 proxy_read_timeout 协调至关重要。
server {
    listen 80;
    server_name example.com;

    location /stream {
        proxy_pass http://backend_cluster;
        proxy_buffering off;
        proxy_set_header Connection "close";

        # 关键配置:仅在发生错误或超时时才进行故障转移
        # 注意:对于流式数据,需确保 timeout 设置合理
        proxy_next_upstream error timeout http_502 http_503;

        # 设置读取超时时间,与 proxy_next_upstream timeout 配合
        proxy_read_timeout 60s;
    }
}

# upstream 定义
upstream backend_cluster {
    server 192.168.1.1:8080;
    server 192.168.1.2:8080;
}
上述配置展示了如何在 Nginx 中设置流式请求的故障转移。首先,proxy_buffering off 确保数据实时传输。其次,proxy_next_upstream 明确指定了触发转移的条件:error、timeout、http_502 和 http_503。最后,proxy_read_timeout 定义了等待数据的最大时间。当上游服务器在 60 秒内无响应时,Nginx 会触发 timeout 事件,进而根据 proxy_next_upstream 的配置切换到下一个可用节点。

















