








在sql中正确选择行级锁或表级锁优化数据修改,核心在于根据事务的粒度、并发需求以及数据分布特征来决定。对于高并发且只涉及少量特定记录的场景,应优先使用支持行级锁的引擎(如innodb)并配合精确索引进行更新,以最小化锁竞争;而对于批量全表扫描、初始化或维护性操作,则应接受表级锁带来的阻塞,以换取执行效率和管理简便性。具体做法是:确保update语句的where子句能命中唯一索引或主键,从而触发行锁而非间隙锁或表锁;若必须处理大量数据,可考虑分批次提交或使用显式的表锁指令。
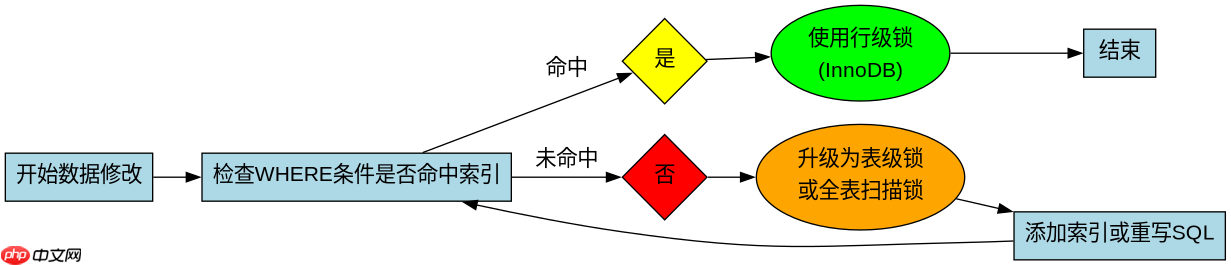
如何避免UPDATE语句意外升级为表锁
要避免UPDATE语句从预期的行级锁退化为表级锁,关键在于确保查询条件能够利用索引。如果WHERE子句中的列没有索引,或者使用了函数、类型转换导致索引失效,数据库引擎将不得不扫描全表,此时为了数据一致性,通常会锁定所有扫描过的行,甚至整个表。因此,必须检查执行计划,确认使用了正确的索引路径。此外,在InnoDB中,即使有索引,如果查询范围过大或使用了非等值判断,也可能引发间隙锁(Gap Lock),这在某些情况下会阻碍其他事务插入数据,表现为类似表锁的效果。解决之道是细化查询条件,尽量使用等值查询,并确保相关列上有合适的B+树索引。
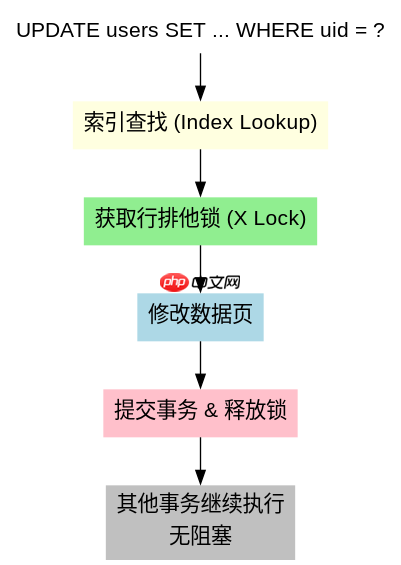
-- 假设有一个用户表 users,uid 为主键
-- 错误示范:对 name 字段进行模糊查询,可能导致全表扫描和锁升级
UPDATE users SET status = 1 WHERE name LIKE '%admin%';

-- 正确示范:通过主键或唯一索引精确更新,仅锁定单行
UPDATE users SET status = 1 WHERE uid = 1001;
上述代码展示了两种不同的更新方式。第一种由于缺乏有效索引,可能锁定多行甚至全表,严重影响并发性能。第二种通过主键uid定位,InnoDB引擎只会对uid=1001这一行加排他锁(X锁),其他事务仍可并行修改其他行。预期结果是,第二种操作的锁持有时间极短,且锁对象单一,不会阻塞无关的事务。
何时应该主动使用表级锁进行批量操作
当需要进行大规模数据迁移、报表生成或全表结构变更时,主动使用表级锁往往是更优的选择。虽然表级锁会阻塞所有其他对该表的读写操作,但它避免了行级锁在海量数据下产生的巨大内存开销和复杂的死锁检测成本。在这种场景下,数据的完整性比并发度更重要。可以通过START TRANSACTION配合LOCK TABLES语句,或者在某些数据库中直接使用ALTER TABLE等DDL命令(它们通常隐含表锁)来实现。这种做法适用于低峰期维护,或者业务允许短暂停服的场景。关键在于权衡:如果并发请求极少,而数据量极大,表锁反而能简化事务管理,提高整体吞吐量。

-- MySQL 示例:显式获取表级写锁
LOCK TABLES users WRITE;

-- 执行批量更新
UPDATE users SET last_login = NOW();

-- 释放锁
UNLOCK TABLES;
这段代码演示了如何在MySQL中手动控制表锁。首先通过LOCK TABLES获取users表的写权限,此时其他会话无法读取或写入该表。接着执行批量更新,最后通过UNLOCK TABLES释放资源。这种模式确保了批量操作的原子性和隔离性,避免了在长时间运行的大事务中出现部分成功部分失败的不一致状态。预期结果是,在LOCK和UNLOCK之间,只有当前会话能操作users表,其他会话将被阻塞直到锁释放。
基于事务隔离级别下的锁行为差异
在默认的可重复读(Repeatable Read)隔离级别下,InnoDB使用Next-Key Locks(记录锁+间隙锁)来防止幻读,这可能导致看似简单的SELECT FOR UPDATE也会锁定相邻的记录。如果在串行化(Serializable)级别下,所有查询都会隐式加上共享锁,进一步加剧锁竞争。因此,理解当前事务的隔离级别对锁选择至关重要。如果业务允许一定的脏读或不可重复读,可以降低隔离级别至读已提交(Read Committed),从而减少间隙锁的使用,使锁机制更接近传统的行级锁行为,提升并发能力。但在金融等强一致性场景中,必须维持RR或更高,并接受相应的锁开销。开发者需根据数据的一致性要求,调整隔离级别以平衡锁的粒度与系统的吞吐量。















