








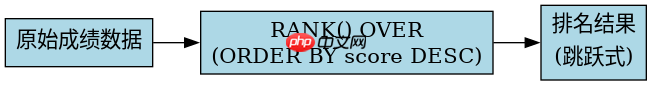
在sql中使用rank函数解决成绩并列统计问题,核心在于利用其“跳跃排序”的特性处理相同分数。只需在select语句中指定over子句并按成绩降序排列即可,相同分数的记录会获得相同的排名,而下一个不同分数的排名将跳过中间空缺的序号。这种方法适用于需要保留并列名次且后续名次顺延的业务场景。
RANK与DENSE_RANK在处理并列时的具体差异是什么
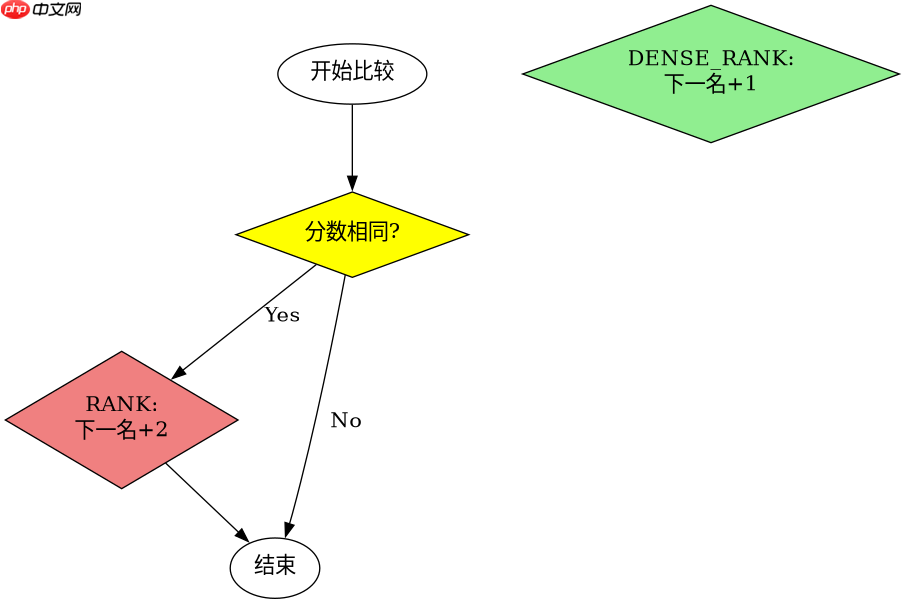
RANK函数和DENSE_RANK函数的主要区别在于对并列后名次的处理方式。RANK会产生跳跃排名,例如两个第一名后直接是第三名;而DENSE_RANK产生连续排名,两个第一名后是第二名。选择哪个函数取决于业务是否允许名次出现断层。
CREATE TABLE scores (student_id INT, score DECIMAL(5,2));
INSERT INTO scores VALUES (1, 90), (2, 90), (3, 85), (4, 80);

-- 使用 RANK
SELECT student_id, score, RANK() OVER (ORDER BY score DESC) as rank_result FROM scores;
-- 结果: 1->1, 2->1, 3->3, 4->4

-- 使用 DENSE_RANK
SELECT student_id, score, DENSE_RANK() OVER (ORDER BY score DESC) as dense_rank_result FROM scores;
-- 结果: 1->1, 2->1, 3->2, 4->3
当存在空值或NULL时RANK函数如何处理
RANK函数在处理NULL值时,默认将其视为最小值排在最后(DESC排序)或最前(ASC排序),并赋予相应的排名。如果希望忽略NULL值或将其视为特定分数,需要在查询前通过COALESCE函数进行预处理,否则NULL值的排名可能会干扰正常的统计逻辑。
基于程序中某个输入、条件或结果的具体问题
在实际应用中,如果输入数据包含重复的学生ID但不同的分数,RANK函数会对每一行独立计算排名,而不是合并学生总分。这意味着同一个学生可能出现在多个排名位置,这通常不符合“按学生统计”的预期。解决此问题的做法是在应用RANK之前先使用GROUP BY聚合分数,或者使用ROW_NUMBER配合DISTINCT来确保唯一性。


















