








在 apache 的 rewriterule 中匹配带参数的 url,核心在于理解正则表达式仅作用于 url 的路径部分(path),而查询字符串(query string)默认不参与匹配。要处理参数,必须使用 %{query_string} 服务器变量配合 rewritecond 指令进行条件判断,并在重写时通过 [qsa] 标志保留原有参数或使用 ? 截断旧参数。
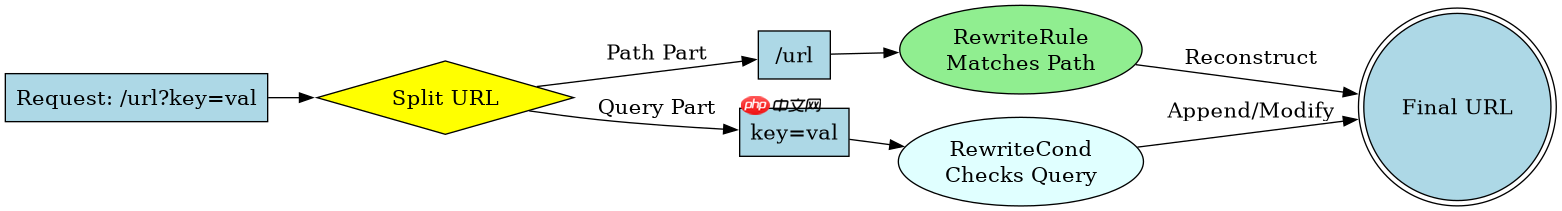
如何匹配路径并保留原始查询参数?
当需要将 /old-page 重定向到 /new-page 且希望用户带来的 ?id=123 等参数自动附加到新 URL 后时,应使用 [QSA](Query String Append)标志。Apache 会自动将当前请求中的查询字符串追加到替换字符串的末尾,无需手动编写复杂的正则来捕获和重组参数。
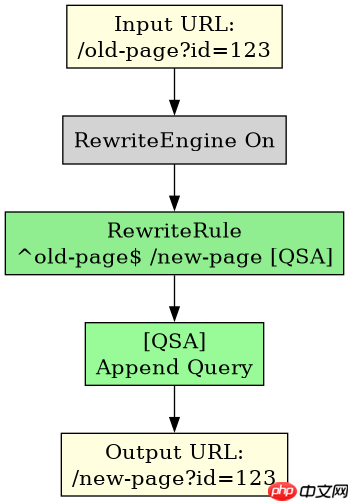
# 启用重写引擎
RewriteEngine On

# 规则:匹配 /old-page,重写到 /new-page
# [QSA] 标志确保原有的 ?key=value 被保留并追加
RewriteRule ^old-page$ /new-page [L,QSA]
上述配置在处理 /old-page?foo=bar 时,最终输出的 URL 为 /new-page?foo=bar。如果替换字符串中已经包含问号(例如 /new-page?fixed=val),[QSA] 会将原参数以 & 连接追加,形成 /new-page?fixed=val&foo=bar。这是处理大多数 SEO 友好型重定向的标准做法。

通过Apache Tika Server REST API从1400多种文件格式中提取文本和元数据。处理PDF、DOCX、PPTX、电子邮件归档以及带有MIME类型检测的嵌入式文档提取。
如何根据特定参数值执行不同的重写逻辑?
若需根据查询字符串中的具体键值对决定跳转目标(例如区分 ?type=pdf 和 ?type=html),则不能仅靠 RewriteRule,必须引入 RewriteCond 检查 %{QUERY_STRING}。此时正则表达式用于匹配参数串的具体格式,如 (^|&)type=(pdf|html)。

RewriteEngine On

# 条件:查询字符串中包含 type=pdf
RewriteCond %{QUERY_STRING} (^|&)type=pdf(&|$)
# 动作:重定向到 PDF 专用页面,并清除原参数 (使用 ? 截断)
RewriteRule ^content/(.*)$ /pdf-viewer/$1? [L,R=301]

# 条件:查询字符串中包含 type=html
RewriteCond %{QUERY_STRING} (^|&)type=html(&|$)
# 动作:重定向到 HTML 专用页面
RewriteRule ^content/(.*)$ /html-viewer/$1? [L,R=301]
在此场景中,输入 /content/doc1?type=pdf 会触发第一个条件块,重定向至 /pdf-viewer/doc1(注意末尾的 ? 清除了原参数)。若未指定类型或类型不匹配,则不会触发重写,保持原 URL 不变。这种基于条件的分支逻辑是处理复杂路由参数的标准模式。
当查询字符串为空时,RewriteRule 的行为是什么?
在 Apache 中,如果请求 URL 不包含任何参数(即没有问号 ?),%{QUERY_STRING} 变量的值为空字符串。此时,依赖 %{QUERY_STRING} 的 RewriteCond 通常不会匹配,除非条件明确允许空值。此外,RewriteRule 本身始终只匹配路径部分,因此 /path 和 /path? 在规则层面被视为相同的路径输入,但后续的参数处理逻辑会因是否存在实际参数字符串而不同。


















