








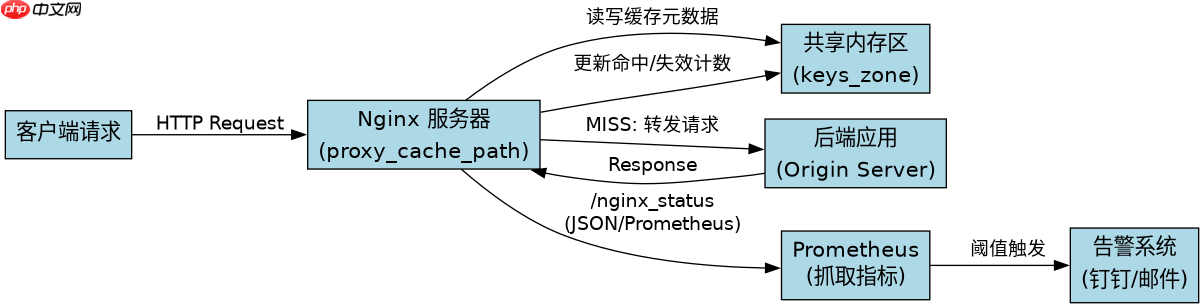
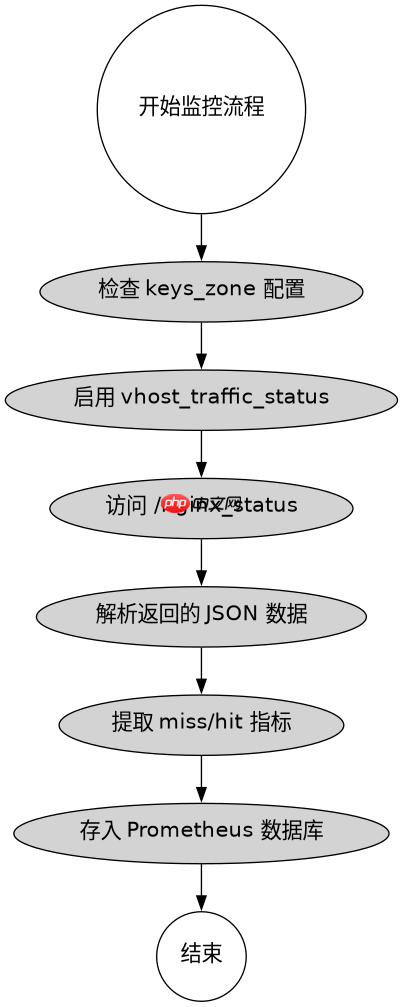
配置 nginx 缓存失效监控的核心在于利用 proxy_cache_path 的 keys_zone 参数开启共享内存统计,并通过第三方模块 nginx-module-vts 或 ngx_http_upstream_check_module 暴露实时状态接口。具体做法是在 nginx 主配置中启用 vhost_traffic_status 模块,该模块会自动收集缓存命中率、大小及键数量等指标,随后通过 http 接口输出 json 数据供 prometheus 等监控系统抓取。这样可以直接获取缓存区的实际运行状况,无需依赖日志解析。
如何开启并验证缓存命中统计功能
要获取缓存失效与命中的基础数据,必须确保 Nginx 编译时包含 ngx_http_proxy_module 并正确配置了 keys_zone。这一步是后续所有监控的基础,因为如果没有定义共享内存区域,Nginx 不会记录任何缓存元数据。配置完成后,可以通过访问特定的状态页面来验证数据是否正在生成。
{
    "server": {
        "cache": {
            "zone": {
                "my_cache": {
                    "size": "10m",
                    "used": "5.2m",
                    "miss": 120,
                    "hit": 880
                }
            }
        }
    }
}
上述 JSON 结构展示了典型的缓存统计输出。其中 miss 字段代表未命中(即缓存失效或未找到)的请求数,hit 代表命中数。开发者应重点关注 miss 值的突增,这通常意味着后端服务变更导致缓存键失效,或者 TTL 设置过短。通过对比这两个数值,可以计算出当前的缓存命中率,从而判断缓存策略的有效性。

如何实现缓存失效的自动化告警
在获取到缓存统计数据后,下一步是将这些数据接入监控系统以实现自动化告警。常用的方案是使用 nginx-prometheus-exporter 将 Nginx 的状态数据转换为 Prometheus 格式。配置时,需要确保 exporter 能够访问到 Nginx 暴露的状态接口,并在 Prometheus 中设置针对 nginx_http_requests_total 和缓存相关指标的告警规则。当缓存命中率低于设定阈值(如 90%)或 MISS 请求速率超过每秒一定数量时,触发告警通知。

# nginx.conf 片段
location /nginx_status {
    stub_status on;
    access_log off;
}

# vhost_traffic_status 配置
vhost_traffic_status_zone;
vhost_traffic_status_bypass_limit on;
在实际部署中,除了基础的命中率,还需要关注缓存空间的占用情况。如果 used 字段持续增长且接近 size 上限,说明缓存驱逐机制正在频繁工作,可能导致更多的 MISS。此时应调整 max_size 或优化缓存键的粒度。通过 Prometheus 的 Alertmanager,可以将这些异常状态发送给钉钉、企业微信或邮件,确保运维团队能及时处理缓存失效问题。
基于 proxy_cache_path 配置的具体问题
在程序中,proxy_cache_path 指令的 levels 和 keys_zone 参数直接决定了缓存文件的存储结构和内存统计的准确性。如果 levels 配置不当,可能导致缓存文件分布不均,进而影响 I/O 性能;而 keys_zone 的大小则限制了可跟踪的缓存键数量。若 keys_zone 过小,超出部分的缓存键将无法被统计,导致监控数据失真。因此,必须根据预期的并发量和缓存键总数合理分配内存,确保监控数据的完整性。


















