








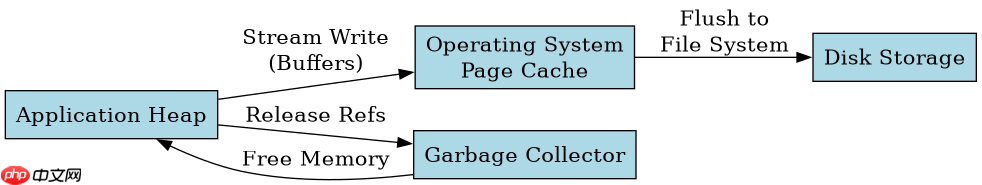
处理大对象序列化时,应放弃一次性加载到内存的默认方式,改用流式分块读写或基于文件映射(mmap)的机制,将数据分批写入磁盘或网络通道。具体做法是调用支持流式输出的序列化库接口,设置合理的缓冲区大小,并配合垃圾回收策略释放中间状态。这样可以将堆内存占用从 o(n) 降低至 o(1) 或固定阈值,避免 outofmemoryerror。
使用 Jackson 流式 API 序列化大对象
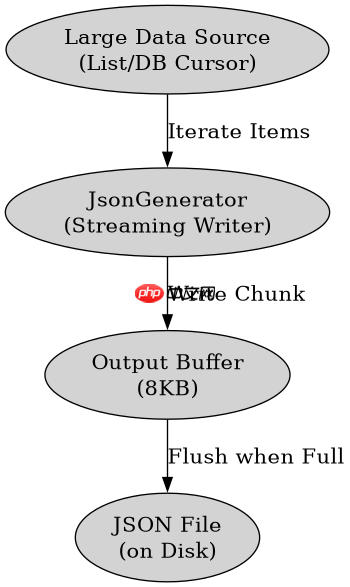
Jackson 的 JsonGenerator 允许逐字段写入,不会构建完整的树模型,从而显著减少内存峰值。通过配置 BufferRecycler 和输出流,可以控制缓冲区的复用与大小,确保在处理 GB 级数据时内存稳定。
import com.fasterxml.jackson.core.JsonFactory;
import com.fasterxml.jackson.core.JsonGenerator;
import java.io.BufferedOutputStream;
import java.io.FileOutputStream;
import java.util.List;

public class LargeObjectSerializer {
    public static void main(String[] args) throws Exception {
        // 模拟一个大对象列表
        List<String> largeData = generateLargeData();

        // 使用流式写入,避免全量加载
        try (FileOutputStream fos = new FileOutputStream("large.json");
             BufferedOutputStream bos = new BufferedOutputStream(fos, 8192);
             JsonFactory factory = new JsonFactory();
             JsonGenerator gen = factory.createGenerator(bos)) {

            gen.writeStartArray();
            for (String item : largeData) {
                gen.writeString(item); // 逐条写入,不构建内存树
            }
            gen.writeEndArray();
            gen.flush();
        }
        System.out.println("Serialization completed with streaming.");
    }

    private static List<String> generateLargeData() {
        // 实际场景中这里可能是数据库游标或外部流
        return List.of("data1", "data2", "data3");
    }
}
运行上述代码,预期结果是生成一个包含所有字符串的 JSON 数组文件,且 JVM 堆内存使用率保持平稳,不会出现因构建巨大 JsonNode 树而导致的溢出。关键点在于 JsonGenerator 直接操作底层字节流,而非在内存中组装对象图。
立即学习“Java免费学习笔记(深入)”;

在代码库出现结构漂移之前,扫描JS或TS代码库中的禁止导入、循环依赖、孤立模块和其他依赖规则违规情况。
利用 MappedByteBuffer 优化超大文件读取
对于已经存在的大文件,使用 Java NIO 的 MappedByteBuffer 可以将文件部分映射到虚拟内存,由操作系统管理分页,应用层无需将全部文件内容读入堆内存。这种方式适合随机访问或顺序扫描超大日志/数据文件。

import java.io.RandomAccessFile;
import java.nio.MappedByteBuffer;
import java.nio.channels.FileChannel;

public class LargeFileReader {
    public static void main(String[] args) throws Exception {
        String filePath = "large_data.bin";
        long fileSize = new java.io.File(filePath).length();

        // 只映射前 1MB 进行演示,实际可按需映射不同区间
        int mapSize = 1024 * 1024;

        try (RandomAccessFile raf = new RandomAccessFile(filePath, "r");
             FileChannel channel = raf.getChannel()) {

            // 映射文件片段到内存
            MappedByteBuffer buffer = channel.map(FileChannel.MapMode.READ_ONLY, 0, mapSize);

            // 处理映射区域的数据
            processBuffer(buffer);

            // 清理引用,帮助 GC 回收映射页(OS 负责实际物理页回收)
            buffer = null;
        }
        System.out.println("Mapped read completed.");
    }

    private static void processBuffer(MappedByteBuffer buffer) {
        // 示例:遍历字节
        while (buffer.hasRemaining()) {
            byte b = buffer.get();
            // 业务逻辑处理
        }
    }
}
该程序的预期结果是能够高效读取指定大小的文件片段,内存占用仅限于映射的大小(如 1MB),而非整个文件大小。当 buffer 引用被置空后,JVM 不再持有对该内存区域的强引用,操作系统会在需要时交换页面。注意 MapMode.READ_ONLY 确保不会意外修改文件,且避免了写回开销。
流式处理中如何避免中间结果累积导致内存泄漏
在使用流式序列化或反序列化时,如果循环体内创建了临时对象且未正确释放,或者使用了缓存机制未限制大小,仍可能导致内存增长。关键在于确保每个批次处理完后,相关资源被显式关闭或引用被清除,并且序列化器本身不保留历史状态。
在上述 Jackson 示例中,JsonGenerator 是无状态的流处理器,每调用一次 writeString 仅将当前值写入缓冲区,缓冲区满后刷出,不会累积之前的字段。若使用自定义 Serializer,必须确保 serialize 方法内部不创建长期持有的集合。例如,若在循环中拼接 StringBuilder 而不重置,内存会线性增长。正确的做法是在每次迭代结束时清空或使用新的局部变量。此外,对于反序列化,使用 JsonParser 的 nextToken() 逐个解析,并在处理完每个元素后立即丢弃其引用,可防止旧对象滞留堆中。


















