








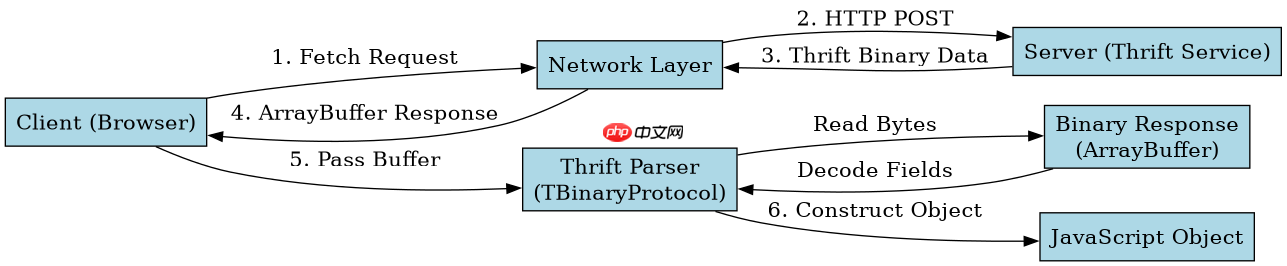
javascript fetch api 处理 thrift 数据的核心在于将二进制流解码为 tbinaryprotocol 格式,并手动解析字段标签和类型。由于浏览器环境缺乏原生 thrift 库,通常的做法是获取 arraybuffer,然后使用 javascript 实现的 thrift 客户端(如 thrift.js)进行反序列化,或者编写自定义的字节解析逻辑来提取特定字段。
Fetch 请求如何获取原始二进制流
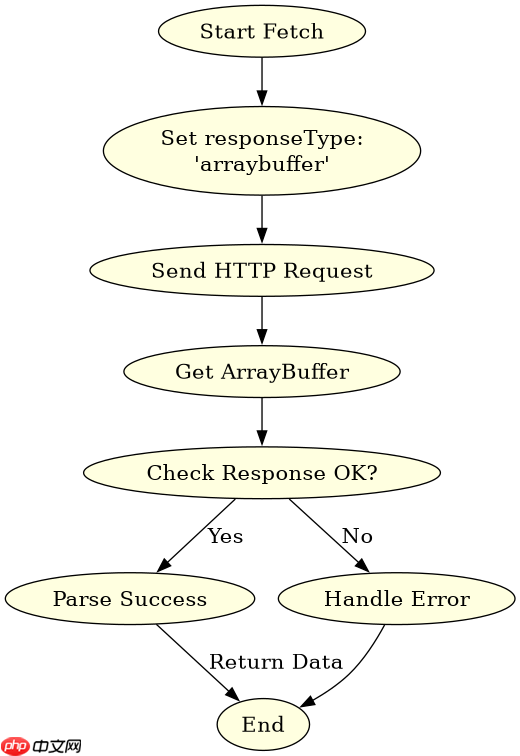
Fetch 接口默认返回 JSON 或文本,要处理 Thrift 的二进制响应,必须设置 responseType 为 arraybuffer。这确保了网络层传输的数据以原始字节数组形式暴露给 JavaScript,避免被自动编码破坏。获取到 Buffer 后,即可将其传递给 Thrift 解析器。
const url = '/api/thrift-endpoint';

fetch(url, {
  method: 'POST',
  headers: {
    'Content-Type': 'application/x-thrift'
  },
  body: serializeRequestData() // 假设这是你的请求序列化逻辑
})
.then(response => {
  if (!response.ok) {
    throw new Error('Network response was not ok');
  }
  return response.arrayBuffer();
})
.then(buffer => {
  // 将 ArrayBuffer 转换为 Thrift 可读的格式
  const result = parseThriftResponse(buffer);
  console.log(result);
})
.catch(error => {
  console.error('Fetch error:', error);
});
上述代码展示了标准的 Fetch 调用流程。关键点在于 response.arrayBuffer() 这一步,它直接返回底层的二进制数据。如果服务端使用的是 TBinaryProtocol,这个 Buffer 就是标准的 Thrift 帧结构。开发者需要确保请求头中的 Content-Type 与服务端期望的一致,通常是 application/x-thrift 或自定义的 MIME 类型。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何在浏览器中解析 TBinaryProtocol 数据
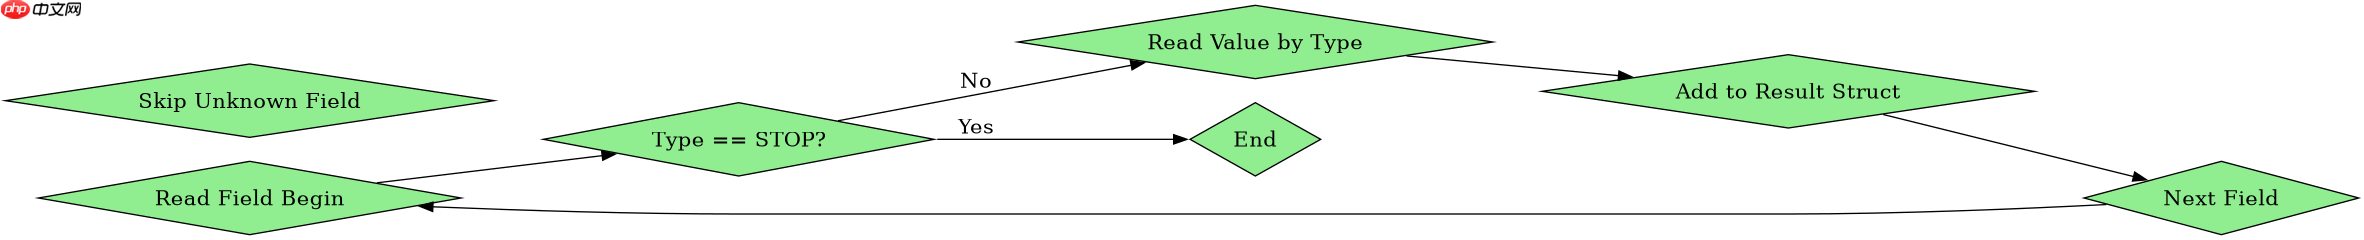
在浏览器环境中解析 Thrift 数据,最稳健的方式是使用基于 JavaScript 的 Thrift 库,例如 thrift npm 包提供的客户端实现。这些库提供了 TBinaryProtocol 类,能够读取 Buffer 并按照 Thrift 协议规范解析字段 ID、类型和值。如果没有现成库,则需要手动实现一个简易的变长整数(VarInt)和类型读取器。
// 假设使用 thrift npm 包
const thrift = require('thrift');
const MyService = require('./gen-nodejs/MyService');

// 创建二进制协议实例
const protocol = new thrift.TBinaryProtocol(
  new thrift.TBufferedTransport(
    new thrift.TBufferedTransport(buffer)
  )
);

// 定义一个简单的读取函数
function readStruct(protocol) {
  const struct = {};
  let fieldId;
  let fieldType;

  while (true) {
    fieldId = protocol.readFieldBegin();
    fieldType = fieldId.type;

    if (fieldType === thrift.TType.STOP) {
      break;
    }

    // 根据 fieldId 和 fieldType 读取具体值
    switch (fieldId.id) {
      case 1:
        struct.name = protocol.readString();
        break;
      case 2:
        struct.value = protocol.readI32();
        break;
      default:
        protocol.skip(fieldType);
    }
  }
  protocol.readFieldEnd();
  return struct;
}

const parsedData = readStruct(protocol);
这段代码演示了如何使用 TBinaryProtocol 逐字段解析二进制流。Thrift 协议通过字段 ID 和类型标记来组织数据,解析器需要循环读取直到遇到 STOP 标记。对于未知字段,使用 protocol.skip() 跳过以保证解析器状态一致。这种方法适用于任何遵循标准 Thrift 二进制编码的服务端响应。如果数据量较大,建议使用 TBufferedTransport 来提高 I/O 效率。
如何处理 Thrift 响应中的异常状态码
Thrift 协议允许在服务端抛出异常并在响应中携带异常信息。在浏览器端解析时,除了正常的数据结构,还需要检查响应中是否包含异常标记。TBinaryProtocol 在解析开始时可能会遇到异常类型标记,此时应直接抛出错误而不是尝试解析为数据结构。正确处理异常能避免前端因解析失败而崩溃。
function parseWithExceptionHandling(buffer) {
  const protocol = new thrift.TBinaryProtocol(
    new thrift.TBufferedTransport(buffer)
  );

  try {
    // 尝试读取结果
    const result = readStruct(protocol);
    return { success: true, data: result };
  } catch (e) {
    // 检查是否是 Thrift 异常
    if (e instanceof thrift.ThriftException) {
      return {
        success: false,
        error: e.message,
        code: e.type
      };
    }
    throw e; // 其他解析错误重新抛出
  }
}
在解析过程中捕获 ThriftException 是关键步骤。Thrift 客户端库在遇到非正常结束的结构时通常会抛出此类异常。通过区分异常类型和普通的解析错误,前端可以给出更友好的用户提示,例如“服务暂时不可用”或“参数错误”,而不是通用的“解析失败”。这种处理方式确保了即使服务端返回了预期的错误状态,前端也能优雅地接收和处理。


















