








javascript web worker 无法直接传递 idbtransaction 对象,因为该对象不是结构化克隆算法支持的类型。正确的做法是在主线程中打开数据库并获取 idbdatabase 实例,然后通过 postmessage 将数据库实例发送给 worker。worker 收到后调用其 transaction() 方法创建新的事务,并在事务内部操作数据。
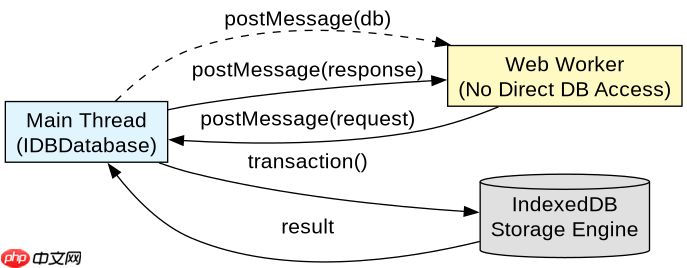
为什么不能直接传递 IDBTransaction?
Web Workers 与主线程之间的通信基于消息队列,底层使用结构化克隆算法(Structured Clone Algorithm)来序列化数据。这个算法支持基本数据类型、数组、普通对象以及部分内置对象(如 Date、RegExp),但明确排除了浏览器特定的 DOM 和 API 对象,包括 IDBTransaction、IDBObjectStore 和 IDBCursor。这些对象持有对浏览器内部存储引擎的引用,且状态是动态变化的,因此无法被序列化或跨线程复制。如果尝试直接发送 IDBTransaction,会抛出 DataCloneError。
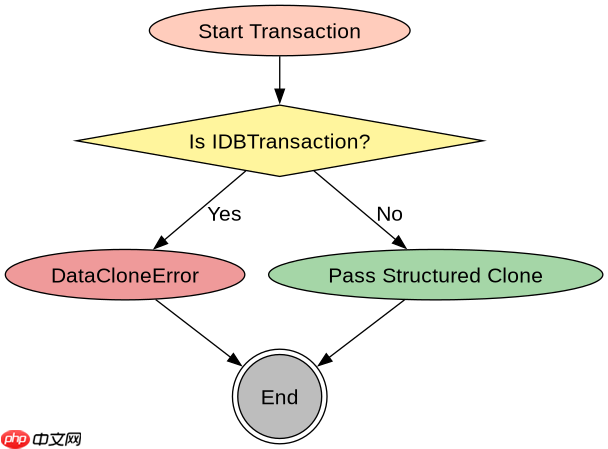
// 错误示范:这会抛出 DataCloneError
const transaction = db.transaction('users', 'readwrite');
worker.postMessage(transaction); // Error: Failed to execute 'postMessage' on 'Worker'
由于 IDBTransaction 依赖于特定的数据库连接上下文,它必须在拥有该连接的同一个线程中被创建和使用。这意味着你不能在 Worker 中复用主线程已经开启的事务,也不能把事务本身当作数据打包发送。解决这个问题的核心思路是传递“权限”而非“状态”,即传递能够发起新事务的数据库句柄。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何在 Worker 中安全地执行数据库操作?
要实现跨线程的 IndexedDB 操作,必须遵循“主线程持有连接,Worker 请求操作”的模式。主线程负责维护 IDBDatabase 实例,而 Worker 只负责处理业务逻辑和数据计算。当 Worker 需要读写数据时,它向主线程发送一个包含操作指令的消息。主线程接收到指令后,利用已有的数据库连接创建一个新的 IDBTransaction,执行相应的增删改查操作,并将结果返回给 Worker。

// 主线程 (main.js)
const worker = new Worker('worker.js');
let db;

// 初始化数据库
const request = indexedDB.open('MyDatabase', 1);
request.onupgradeneeded = (event) => {
    const database = event.target.result;
    if (!database.objectStoreNames.contains('users')) {
        database.createObjectStore('users', { keyPath: 'id' });
    }
};

request.onsuccess = (event) => {
    db = event.target.result;
    // 将数据库实例传递给 Worker
    worker.postMessage({ type: 'INIT_DB', db: db });
};

// 监听来自 Worker 的操作请求
worker.onmessage = (event) => {
    const { type, payload } = event.data;

    if (type === 'ADD_USER') {
        const transaction = db.transaction('users', 'readwrite');
        const store = transaction.objectStore('users');
        const addRequest = store.add(payload.user);

        addRequest.onsuccess = () => {
            worker.postMessage({ type: 'SUCCESS', data: 'User added' });
        };

        addRequest.onerror = (error) => {
            worker.postMessage({ type: 'ERROR', error: error.target.error });
        };
    }
};

// Worker 线程 (worker.js)
self.onmessage = (event) => {
    if (event.data.type === 'INIT_DB') {
        self.db = event.data.db; // 注意:这里实际上不能保存db用于后续直接使用,需通过消息回传
        // 更安全的做法是:Worker 不保存 db 引用,而是每次通过 postMessage 触发主线程操作
        // 但为了演示结构,我们假设 Worker 接收到了某种形式的控制信号
    }
};

// 修正后的 Worker 交互模式
self.onmessage = (event) => {
    if (event.data.type === 'REQUEST_ADD_USER') {
        // Worker 通知主线程添加用户
        // 由于 Worker 没有直接的 db 引用,通常由主线程广播或 Worker 发送消息给主线程
        // 这里展示的是 Worker 发送请求,主线程响应
    }
};
上述代码展示了标准的交互流程。需要注意的是,虽然我们在主线程中成功将 db 对象通过 postMessage 发送给了 Worker,但这并不意味着 Worker 可以直接使用这个 db 对象来创建事务。根据规范,IDBDatabase 也是不可克隆的,但在某些浏览器实现中,如果数据库处于打开状态且同源,可能会允许这种传递行为作为扩展,或者更常见的是,主线程保持数据库打开,Worker 仅发送操作指令。最稳健的做法是:主线程始终持有 IDBDatabase,Worker 发送操作类型和数据,主线程执行操作并回调。如果需要在 Worker 中独立进行大量数据库操作,可以考虑在主线程启动多个 Worker 并分别传递不同的数据库连接副本(如果应用架构允许),或者使用 IndexedDB 的 onversionchange 事件来处理版本更新时的关闭逻辑。在实际开发中,推荐使用封装好的库如 idb 来处理这些复杂的跨线程细节,它们会自动处理消息传递和事务管理。
如何处理并发写入导致的冲突?
当多个 Worker 同时尝试修改同一对象存储中的数据时,可能会发生并发冲突。IndexedDB 的事务是自动隔离的,但如果两个事务试图修改同一个键值,后提交的事务会失败并触发 onerror 事件,错误类型为 ConstraintError 或 VersionError。为了避免这种情况,可以在主线程中实现一个简单的锁机制或重试逻辑。例如,当 Worker 报告写入失败时,主线程可以等待一小段时间后重新尝试该操作。此外,确保每个事务尽可能短小,以减少锁定时间,从而提高并发性能。在处理复杂的数据模型时,还可以考虑使用乐观锁策略,即在数据中包含版本号字段,每次更新时检查版本号是否匹配,如果不匹配则拒绝更新并提示前端刷新数据。


















