








通过 case when 实现动态条件聚合的核心做法是:在 sum()、avg() 等聚合函数内部包裹 case when 表达式,将需要统计的行标记为具体数值(如金额),将不需要统计的行标记为 null。由于大多数聚合函数会自动忽略 null 值,这种写法能在单次扫描中完成多组不同条件的统计,避免多次全表扫描或子查询带来的性能损耗。

如何按状态分组并分别统计订单金额?
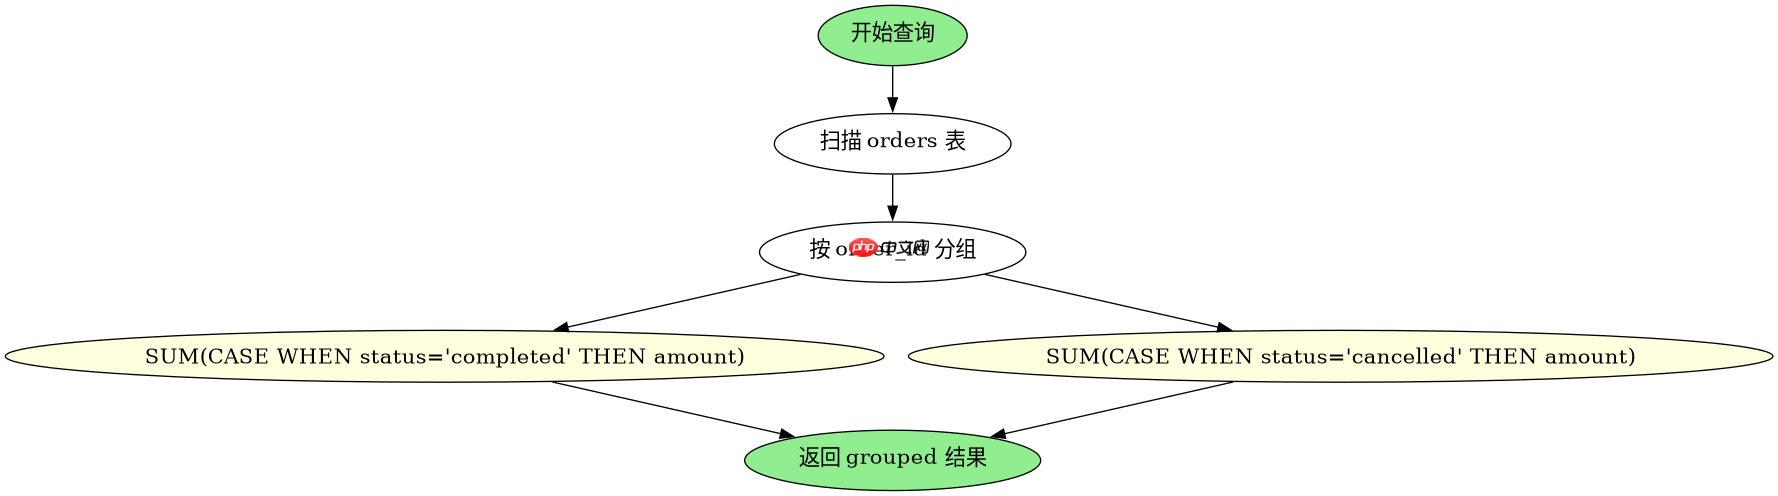
针对“按状态分组并分别统计订单金额”这一需求,可以在 GROUP BY 的基础上,使用多个带条件的 CASE WHEN 配合 SUM 函数。例如,统计“已完成”和“已取消”的订单总额,只需在 SELECT 列表中定义两个独立的列,分别对应不同的判断逻辑。数据库引擎会在分组后逐行计算,符合条件的累加,不符合的视为 NULL 从而被忽略。
SELECT
    order_id,
    SUM(CASE WHEN status = 'completed' THEN amount ELSE 0 END) AS completed_amount,
    SUM(CASE WHEN status = 'cancelled' THEN amount ELSE 0 END) AS cancelled_amount
FROM orders
GROUP BY order_id;
上述代码假设存在一个名为 orders 的表,包含 order_id、status 和 amount 字段。运行该查询后,结果集将包含原始订单 ID,以及两列分别代表该订单下所有已完成订单的金额总和与已取消订单的金额总和。若某订单没有已完成记录,completed_amount 将为 0;若没有已取消记录,cancelled_amount 也将为 0。这种写法确保了即使某些状态不存在,也不会导致查询报错或返回空行。
如何处理跨表关联中的条件计数?
当涉及多表关联时,动态条件聚合同样适用,只需在 CASE WHEN 的判断条件中引用关联表的字段即可。例如,统计每个用户及其关联订单中“高价值”订单的数量,可以通过连接 users 表和 orders 表,并在 COUNT 函数中使用 CASE WHEN 过滤出金额大于特定阈值的记录。这种方法避免了先筛选再计数的繁琐步骤,直接在聚合阶段完成过滤。

SELECT
    u.user_id,
    COUNT(CASE WHEN o.amount > 1000 THEN 1 END) AS high_value_count
FROM users u
LEFT JOIN orders o ON u.user_id = o.user_id
GROUP BY u.user_id;
该示例展示了如何使用 LEFT JOIN 保留所有用户,即使他们没有订单。对于有订单的用户,CASE WHEN 会检查 amount 是否大于 1000,如果是则返回 1,否则返回 NULL。COUNT 函数只统计非 NULL 值,因此最终得到的是高价值订单的数量。如果用户没有任何订单,o.amount 为 NULL,条件不成立,返回 NULL,COUNT 结果为 0。这确保了所有用户都会出现在结果集中,且计数准确无误。
基于程序中某个输入、条件或结果的具体问题
在实际开发中,经常遇到需要根据运行时参数动态调整聚合逻辑的情况。例如,当传入一个特定的 region_code 时,希望只统计该地区的订单,而其他地区不计入。此时,可以将 CASE WHEN 的条件改为匹配传入的参数变量。这种做法使得 SQL 语句具备了一定的灵活性,无需为每个地区编写单独的查询语句。只要确保参数正确传递到 SQL 执行环境中,CASE WHEN 就能根据实际输入动态决定哪些行参与聚合,从而实现真正的动态条件统计。


















