








如何分批删除大量数据以避免事务日志爆满和锁表
在sql server中,通过设置事务大小分段执行delete的核心做法是使用循环结构配合`set rowcount`(或`top`子句)限制每次删除的行数,并在循环内提交事务。具体而言,你需要在一个`while`循环中持续执行带有行数限制的`delete`语句,直到受影响的行数小于设定值时退出循环。这样做可以将巨大的单事务拆分为多个小事务,从而控制事务日志的增长并减少锁竞争。

为什么需要分段删除以及具体的代码实现是什么
分段删除的主要原因是防止长事务导致的事务日志空间耗尽、数据库备份失败以及长时间持有排他锁影响业务可用性。具体的代码实现依赖于一个计数器变量来跟踪剩余待处理的数据量,并通过`@@ROWCOUNT`系统函数来判断当前批次是否还有数据被删除。
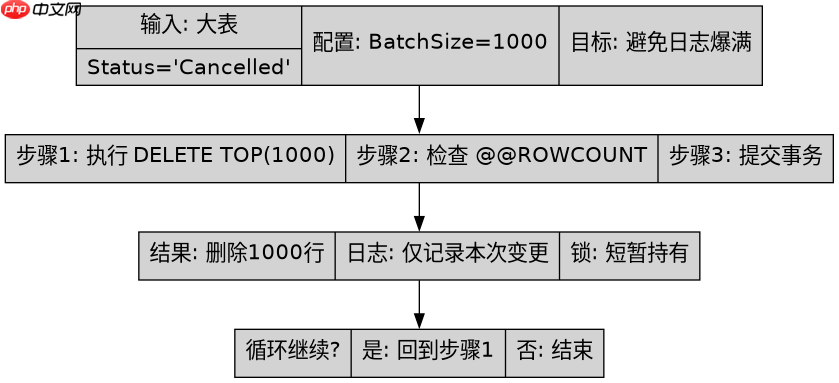
-- 假设我们要删除 [Orders] 表中状态为 'Cancelled' 的记录<br>-- 每次删除 1000 行<br><br>DECLARE @BatchSize INT = 1000;<br>DECLARE @RowsAffected INT = 1;<br><br>-- 使用 TOP (N) 是推荐的方式,兼容所有版本<br>WHILE @RowsAffected > 0<br>BEGIN<br> DELETE TOP (@BatchSize)<br> FROM [Orders]<br> WHERE [Status] = 'Cancelled';<br><br> -- 获取刚才删除的行数<br> SET @RowsAffected = @@ROWCOUNT;<br> <br> -- 可选:在此处添加 CHECKPOINT 或等待,以释放日志空间<br> -- 例如:WAITFOR DELAY '00:00:01';<br>END
上述代码的预期结果是:[Orders] 表中所有状态为 'Cancelled' 的记录将被逐批删除,每批最多1000条,直到全部清除。每次 `DELETE` 操作都会立即提交,因此事务日志不会无限增长。
基于程序中某个输入、条件或结果的具体问题
当删除条件涉及复杂索引或存在外键约束时,分段删除可能会遇到性能瓶颈或死锁风险。具体问题是:如果删除操作触发了级联更新或删除,或者因为缺少合适的索引导致每次扫描全表,分段删除的效果会大打折扣甚至引发死锁。
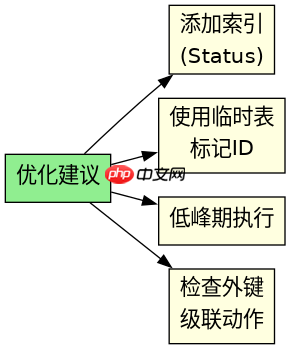
在这种情况下,确保删除列上有适当的索引至关重要。例如,如果按 `[Status]` 删除,应确保该列有非聚集索引。此外,如果数据量极大,可以考虑在低峰期执行,或使用 `WITH (TABLOCKX)` 提示在特定场景下提升批量删除性能,但这会完全锁定表,需权衡业务影响。另一种高级策略是使用临时表标记要删除的ID,然后分批删除这些ID,以减少锁的范围。


















