








在sql server 2022中,使用视图优化分页查询性能的核心做法是结合“索引视图”与“offset-fetch”语法。通过创建包含主键的索引视图,可以将排序和过滤逻辑下推至存储层,减少网络传输的数据量并避免重复计算。具体实现时,需确保视图定义满足确定性要求,并在其上建立唯一聚集索引以启用物理存储。调用时直接使用视图名配合分页参数,即可利用预计算的索引结构加速数据检索。

如何构建支持分页的索引视图
构建索引视图的关键在于满足SQL Server的严格限制,特别是必须包含SCHEMABINDING且视图中引用的列必须是确定性的。对于分页场景,通常需要对结果集进行排序,因此必须在视图中显式包含用于排序的列,并为其建立唯一聚集索引。这样,数据库引擎会在底层维护一个按特定顺序排列的物理表,分页查询可以直接在该有序结构上进行定位,从而大幅提升效率。
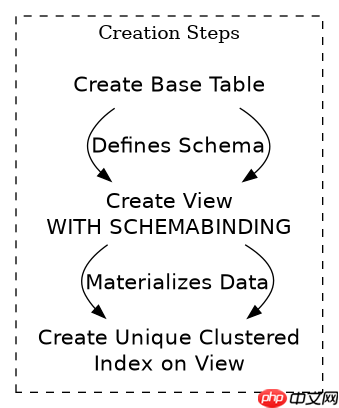
-- 创建基础表示例
CREATE TABLE dbo.Orders (
    OrderID INT PRIMARY KEY,
    CustomerID INT NOT NULL,
    OrderDate DATETIME2 NOT NULL,
    TotalAmount DECIMAL(18, 2)
);
GO

-- 创建带SCHEMABINDING的视图
CREATE VIEW dbo.vwOrdersSorted
WITH SCHEMABINDING
AS
SELECT
    OrderID,
    CustomerID,
    OrderDate,
    TotalAmount
FROM dbo.Orders;
GO

-- 创建唯一聚集索引以物化视图
CREATE UNIQUE CLUSTERED INDEX IX_vwOrdersSorted_OrderDate
ON dbo.vwOrdersSorted (OrderDate DESC, OrderID ASC);
GO上述代码首先定义了基础表,然后创建了一个不包含聚合函数的简单视图。关键在于第二步,通过CREATE UNIQUE CLUSTERED INDEX语句,我们强制SQL Server将视图的结果集物理存储在磁盘上,并按OrderDate降序和OrderID升序排列。这种结构使得后续的分页查询无需在运行时进行昂贵的排序操作(Sort Operator),而是直接通过B+树索引快速定位到起始行。
如何在应用程序中执行高效的分页查询
在应用程序层面,应使用标准的OFFSET ... FETCH语法来调用已优化的索引视图。这种方式比传统的基于ROW_NUMBER()或最大ID查找的方法更具可读性,且在现代SQL Server版本中执行计划非常稳定。由于底层视图已经建立了有序的聚集索引,查询优化器能够识别出ORDER BY子句与索引顺序一致,从而选择高效的“Index Seek”而非“Index Scan”或“Table Scan”。此外,只选取需要的列可以进一步减少I/O开销。

-- 高效的分页查询示例
-- 获取第2页,每页10条记录
SELECT
    OrderID,
    CustomerID,
    OrderDate,
    TotalAmount
FROM dbo.vwOrdersSorted
ORDER BY OrderDate DESC, OrderID ASC
OFFSET 10 ROWS FETCH NEXT 10 ROWS ONLY;
GO该查询直接作用于vwOrdersSorted视图。由于视图上的聚集索引已经按OrderDate排序,数据库引擎会直接从索引的第11个节点开始读取,连续提取10行后停止。这种机制避免了全表扫描和内存中的临时排序,显著降低了CPU和I/O消耗。需要注意的是,如果查询条件中包含非索引列的过滤,可能会导致索引失效,因此建议在视图中预先过滤常用条件或在应用层确保过滤条件与索引匹配。
当视图返回空值或数据未更新时会发生什么
当索引视图所依赖的基础表数据发生变化时,SQL Server会自动维护视图的索引一致性,但这一过程需要时间。如果在高并发写入场景下,视图可能暂时反映旧数据状态,或者因锁竞争导致查询阻塞。此外,如果查询条件无法利用视图索引(例如选择了未包含在索引中的列作为过滤条件),优化器可能会选择“视图展开”而非“索引查找”,此时性能优势将消失甚至低于直接查询基表。若基础表为空,视图查询同样返回空结果集,不会报错,但也不会触发任何索引访问。



















