








在sql server 2019中,解决merge join导致的排序倾斜问题,核心在于消除或优化导致数据分布不均的排序操作。具体做法是检查执行计划中的sort算子,确认其输入数据是否因统计信息过期、参数嗅探或数据倾斜而分布不均。通过更新统计信息、使用option (recompile)提示或调整索引以匹配join条件,可以显著减少内存溢出和性能下降的风险。

如何识别Merge JOIN中的排序瓶颈
要识别Merge JOIN中的排序瓶颈,需关注执行计划中Sort算子的资源消耗和警告标志。当Sort算子显示“Spill to TempDB”(溢出到TempDB)时,表明内存不足,这是排序倾斜的直接表现。此外,若Sort算子的估计行数与实际行数差异巨大,通常意味着统计信息不准确,导致优化器选择了低效的Merge JOIN而非Hash JOIN。
-- 示例查询:模拟Merge JOIN场景
SELECT a.id, b.name
FROM TableA a
INNER JOIN TableB b ON a.key = b.key
WHERE a.date > '2023-01-01';

-- 预期结果:若统计信息准确,执行计划应显示Merge JOIN;
-- 若统计信息过期,Sort算子可能溢出,导致性能下降。
如何通过索引优化避免排序倾斜
通过创建覆盖索引或调整现有索引,可以避免Merge JOIN所需的显式排序操作。具体做法是在JOIN条件和过滤列上创建复合索引,确保数据物理有序。例如,在TableA的key和date列上创建索引,可使Merge JOIN直接利用索引顺序,无需额外Sort算子。这不仅能提升性能,还能减少TempDB的使用。

-- 创建优化索引
CREATE INDEX idx_tablea_key_date
ON TableA (key, date);

-- 预期结果:执行计划中Sort算子消失,Merge JOIN直接利用索引顺序,
-- 性能显著提升,无TempDB溢出风险。
统计信息过期对Merge JOIN的影响及修复方法
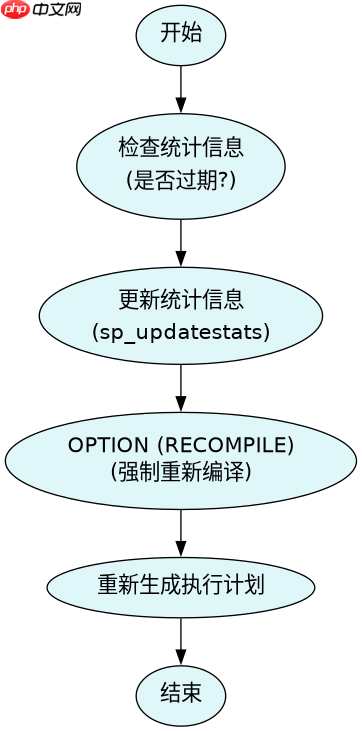
统计信息过期会导致优化器错误估计数据分布,从而选择Merge JOIN并引发排序倾斜。修复方法是手动更新相关表的统计信息,或使用sp_updatestats存储过程批量更新。更新后,重新运行查询,观察执行计划是否改善。若仍存在问题,可结合OPTION (RECOMPILE)提示强制重新编译查询计划,确保使用最新统计信息。
,


















