








在 sql server 中,使用 grouping sets 可以在单次查询中生成多个维度的聚合结果,替代传统的多次 group by 或 cube / rollup 操作。只需将需要组合的列分组放入括号内,并用逗号分隔,数据库引擎会自动计算每一组的数据并合并输出。若某行未包含特定列的分组,该列值显示为 null,可通过 grouping() 函数区分是空值还是聚合产生的缺失维度。

如何按部门和职位分别统计薪资总和?
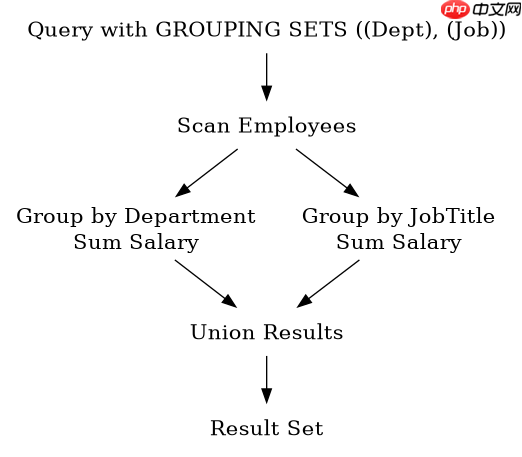
要实现按部门单独统计和按职位单独统计,可以将 Department 和 JobTitle 分别作为独立的分组集传入 GROUPING SETS。这样查询会返回两行数据:一行仅按部门汇总,另一行仅按职位汇总,避免了编写两个独立的查询语句。
SELECT Department, JobTitle, SUM(Salary) AS TotalSalary
FROM Employees
GROUP BY GROUPING SETS (
    (Department),
    (JobTitle)
);
上述代码执行后,结果集将包含两部分:第一部分列出每个部门的薪资总和,其中 JobTitle 列为 NULL;第二部分列出每个职位的薪资总和,其中 Department 列为 NULL。这种写法比使用 UNION ALL 连接两个查询更高效,因为只扫描一次表。
如何同时获取部门、职位及总体的聚合数据?
当需要同时查看部门级、职位级以及全公司的总体汇总时,可以在 GROUPING SETS 中显式加入一个空元组 ()。这表示不基于任何列进行分组,直接计算全局聚合值。结合具体的列分组,可以一次性获得多维度的汇总视图。

SELECT Department, JobTitle, SUM(Salary) AS TotalSalary
FROM Employees
GROUP BY GROUPING SETS (
    (Department, JobTitle),
    (Department),
    (JobTitle),
    ()
);
运行此查询将产生四种类型的行:按部门和职位详细分组的行、仅按部门汇总的行(职位为 NULL)、仅按职位汇总的行(部门为 NULL),以及最后一行代表所有员工的薪资总和(部门和职位均为 NULL)。通过这种方式,开发者可以用一条语句替代复杂的报表逻辑。
如何识别由 GROUPING SETS 生成的虚拟 NULL 值?
在使用 GROUPING SETS 时,区分真实的 NULL 数据和因聚合维度缺失而产生的 NULL 至关重要。可以使用 GROUPING(Department) 和 GROUPING(JobTitle) 函数来实现。如果某行是因为没有对该列进行分组而出现的 NULL,对应的 GROUPING() 函数返回 1;如果是原始数据中的 NULL,则返回 0。
SELECT
    CASE WHEN GROUPING(Department) = 1 THEN 'Total Dept' ELSE ISNULL(Department, 'Unknown') END AS DeptLabel,
    CASE WHEN GROUPING(JobTitle) = 1 THEN 'Total Job' ELSE ISNULL(JobTitle, 'Unknown') END AS JobLabel,
    SUM(Salary) AS TotalSalary
FROM Employees
GROUP BY GROUPING SETS (
    (Department, JobTitle),
    (Department),
    (JobTitle),
    ()
);
在实际应用中,这种技巧常用于生成带有层级标签的报表。例如,当 GROUPING(Department) 为 1 时,说明该行是部门级别的汇总,此时可以将标签标记为 'Total Dept',从而清晰地展示数据的聚合层级。这种方法确保了即使原始数据中存在 NULL,也能准确反映聚合结构。


















