








javascript 通过闭包实现函数记忆化时,内存管理依赖于垃圾回收机制对引用链的追踪。具体做法是利用一个外部作用域中的对象(如 map 或普通对象)存储计算结果,内部函数通过词法环境持有对该对象的引用。只要该内部函数被其他变量引用,其关联的外部作用域及缓存对象就不会被销毁;一旦内部函数失去所有引用,缓存对象随之被释放。需注意避免在缓存中无限累积数据导致内存泄漏。

闭包如何维持缓存数据的引用关系
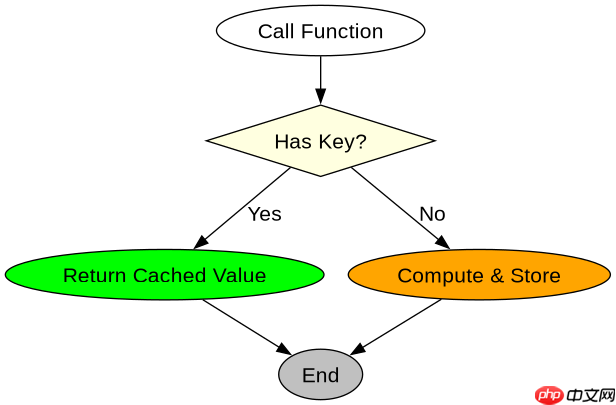
闭包维持缓存数据的关键在于内部函数对外部变量的隐式引用。当定义一个包含缓存逻辑的函数时,JavaScript 引擎会创建一个包含该函数及其词法环境的执行上下文。这个环境不仅包含局部变量,还包含对外部作用域中缓存对象的引用。即使外层函数执行完毕,只要内部函数被返回并赋值给某个变量,这个引用链就依然存在,从而防止缓存对象被垃圾回收器标记为不可达。
function createMemoizer() {
    const cache = new Map();

    return function(key, value) {
        if (cache.has(key)) {
            console.log('Cache hit for:', key);
            return cache.get(key);
        }
        console.log('Cache miss for:', key);
        cache.set(key, value);
        return value;
    };
}

const memoFunc = createMemoizer();
memoFunc('a', 10);
memoFunc('a', 20); // Returns 10在上述代码中,createMemoizer 执行后返回一个匿名函数。这个匿名函数形成了一个闭包,它捕获了 cache 变量。每次调用 memoFunc 时,它都会访问同一个 Map 实例。如果 memoFunc 被重新赋值或不再使用,整个闭包结构(包括 cache)将被垃圾回收。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
不同输入条件下缓存命中与未命中的行为差异
在记忆化函数中,缓存命中和未命中直接影响了内存的使用模式和函数的返回值。当输入键已存在于缓存中时,函数直接返回存储的值,不执行实际计算,也不修改内存状态。若输入键不存在,函数将新值存入缓存,此时内存占用增加。这种差异要求开发者在实现时必须考虑缓存的大小限制,以防止内存溢出。

function optimizedMemoizer(limit) {
    const cache = new Map();

    return function(key, value) {
        if (cache.has(key)) {
            return cache.get(key);
        }

        if (cache.size >= limit) {
            const firstKey = cache.keys().next().value;
            cache.delete(firstKey);
        }

        cache.set(key, value);
        return value;
    };
}

const limitedMemo = optimizedMemoizer(2);
limitedMemo('x', 1);
limitedMemo('y', 2);
limitedMemo('z', 3); // Removes 'x' from cache
此示例展示了带有限制的记忆化函数。当缓存达到上限 limit 时,它会删除最旧的条目以腾出空间。这确保了内存使用保持在可控范围内。如果不加限制,随着调用次数的增加,cache 对象会不断增大,可能导致内存泄漏或性能下降。因此,在实际应用中,应根据业务需求设置合理的缓存策略。
基于缓存对象生命周期结束时的内存释放情况
当记忆化函数不再被任何变量引用时,其关联的缓存对象将立即成为垃圾回收的候选对象。JavaScript 的垃圾回收器会检测到此对象不再可达,并释放其占用的内存。这一过程是自动的,无需手动干预。然而,如果在闭包中持有了对大型 DOM 节点或其他外部资源的引用,即使缓存本身很小,也可能导致内存无法完全释放。因此,确保闭包中只包含必要的数据引用是优化内存管理的关键。

















