








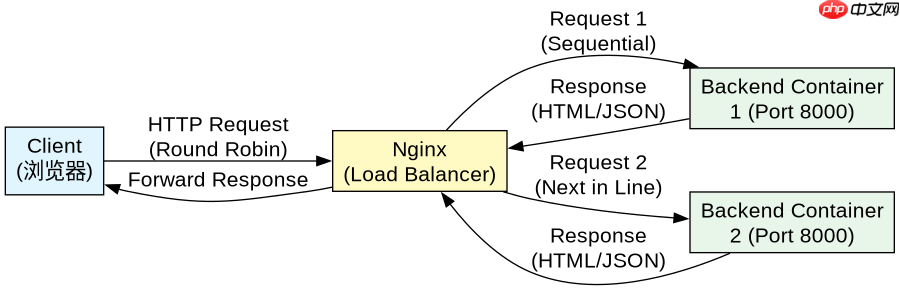
nginx 轮询负载均衡配置容器环境后端,核心在于将 nginx 的 upstream 模块指向运行在 docker 网络中的后端服务地址。具体做法是在 nginx.conf 中定义 upstream 块,使用 server 指令指定容器的 ip 或域名及端口,并在 location 中通过 proxy_pass 调用该上游。nginx 默认采用轮询策略,即按顺序将请求分配给每个后端容器,若某容器响应失败则自动剔除并重试其他容器,直到所有节点均不可用时返回错误。
Docker Compose 如何编排 Nginx 与后端容器网络
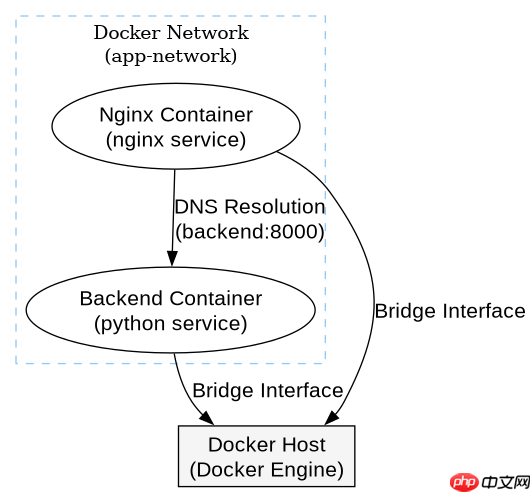
要实现上述配置,首先需要构建一个包含 Nginx 和多个后端服务的 Docker Compose 环境。关键在于利用 Docker 内置的网络功能,让 Nginx 能够解析后端服务的容器名称。在 docker-compose.yml 文件中,只需确保所有服务处于同一个自定义网络下,Nginx 即可通过服务名(如 backend-service)直接访问后端,无需硬编码 IP 地址。这种方式使得后端容器扩容或重启时,IP 变化不会影响 Nginx 的配置。
version: '3.8'
services:
  nginx:
    image: nginx:latest
    ports:
      - "80:80"
    volumes:
      - ./nginx.conf:/etc/nginx/nginx.conf:ro
    depends_on:
      - backend
    networks:
      - app-network

  backend:
    image: python:3.9-slim
    command: python -m http.server 8000
    networks:
      - app-network

networks:
  app-network:
    driver: bridge
在上述配置中,nginx 服务挂载了本地的 nginx.conf 文件,并依赖于 backend 服务启动。两个服务都连接到了名为 app-network 的桥接网络。Docker DNS 会自动将 backend 解析为该网络内的容器 IP。当 Nginx 启动后,它会尝试连接 backend:8000。如果此时只有一个后端容器,Nginx 会直接将流量转发给它。这种基于服务名的配置方式比硬编码 IP 更稳定,因为容器重启后 IP 可能会变,但服务名保持不变。

Nginx 配置文件如何定义轮询逻辑与健康检查
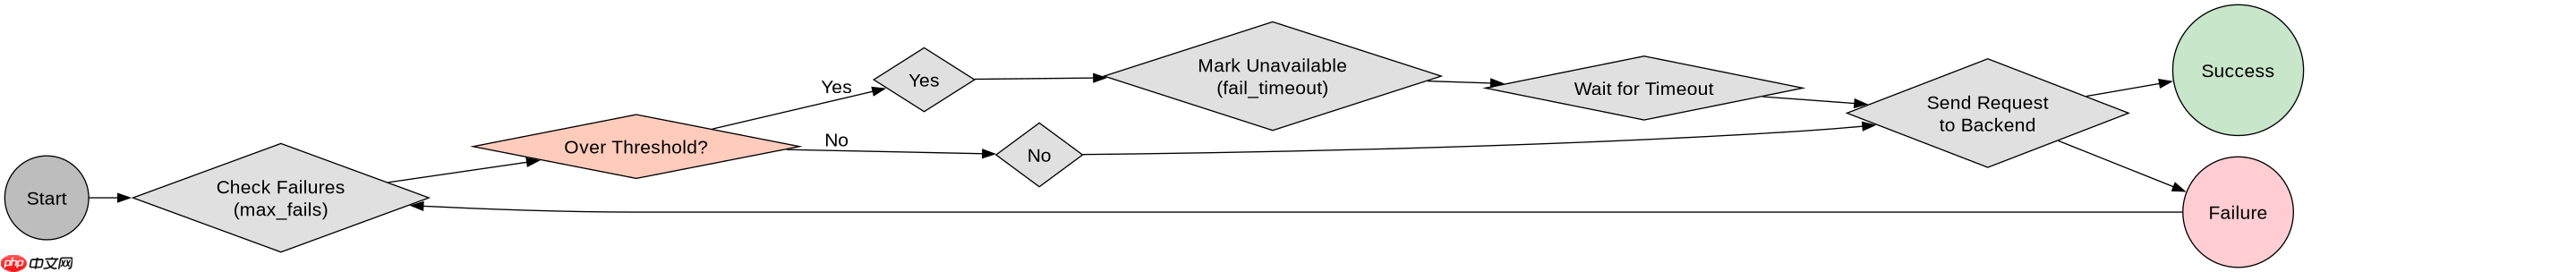
在 Docker 环境中,Nginx 的轮询逻辑完全由 nginx.conf 中的 upstream 块控制。默认情况下,Nginx 使用加权轮询算法,即 weight=1。若要实现严格的轮询,只需在 server 指令中不指定权重或使用默认值。此外,可以通过添加 max_fails 和 fail_timeout 参数来增强健壮性,防止 Nginx 持续向故障容器发送请求。这些参数定义了 Nginx 认为后端失效的标准:如果在 fail_timeout 时间内发生 max_fails 次失败,Nginx 会将该服务器标记为不可用,并在随后的 fail_timeout 时间内不再向其发送请求。
upstream backend_pool {
    server backend:8000 max_fails=3 fail_timeout=30s;
    # 可添加更多后端容器实例
    # server backend-2:8000;
}

server {
    listen 80;
    location / {
        proxy_pass http://backend_pool;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
    }
}
这段配置展示了如何在 Nginx 中定义上游组 backend_pool。其中 server backend:8000 指向 Docker Compose 中定义的 backend 服务。参数 max_fails=3 表示如果连续 3 次请求失败,Nginx 将暂时停止向该服务器发送请求。fail_timeout=30s 定义了失败计数的时间窗口以及服务器被标记为不可用的持续时间。在 location 块中,proxy_pass 指向 http://backend_pool,从而启用轮询机制。当有多个后端容器运行时,Nginx 会依次将请求分发到它们。例如,第一个请求发给 backend:8000,第二个请求发给下一个可用的后端,以此类推。这种机制确保了负载在各个容器间均匀分布,同时通过健康检查参数提高了系统的容错能力。
当后端容器重启时 Nginx 如何处理连接中断
在容器化环境中,后端容器可能因更新、崩溃或资源限制而重启。此时,Nginx 的轮询行为会根据之前配置的 max_fails 和 fail_timeout 做出反应。如果后端容器在重启期间无法接受连接,Nginx 会记录一次失败。当失败次数达到 max_fails 设定的阈值时,Nginx 会将该容器从可用池中暂时移除。这意味着在 fail_timeout 指定的时间内,新的请求不会被发送到这个正在重启的后端容器,而是会被轮询到其他健康的后端实例上。一旦超时时间结束,Nginx 会再次尝试向该容器发送请求,如果成功,则将其重新加入可用池。这种机制确保了在单个容器不可用时,服务不会中断,而是自动切换到其他正常运行的容器,实现了无缝的高可用性。

















