








nginx 配置故障转移的核心做法是在 upstream 块中为后端服务器设置 backup 参数,配合 max_fails 和 fail_timeout 实现自动切换。这种机制在正常流量下对性能几乎没有影响,仅在检测到后端故障并触发切换时产生极小的计算开销。
如何配置 Nginx 的故障转移
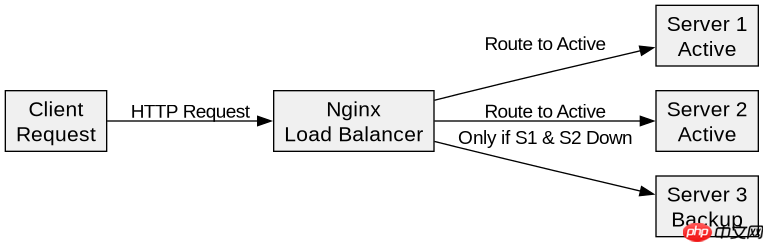
要实现故障转移,需要在 upstream 定义中明确标记备用服务器。Nginx 默认使用轮询(Round Robin)算法分发请求,当主服务器被标记为 backup 后,它只在所有非备份服务器都不可用时才接收流量。
upstream backend {
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;
    server 192.168.1.12:8080 backup;
}
上述配置中,192.168.1.12 是备用节点。只有当 192.168.1.10 和 192.168.1.11 同时无法响应或达到失败阈值时,新请求才会路由到 192.168.1.12。这种配置确保了主集群的高可用性,且备用节点平时不占用处理资源。
故障转移的检测机制与参数调整
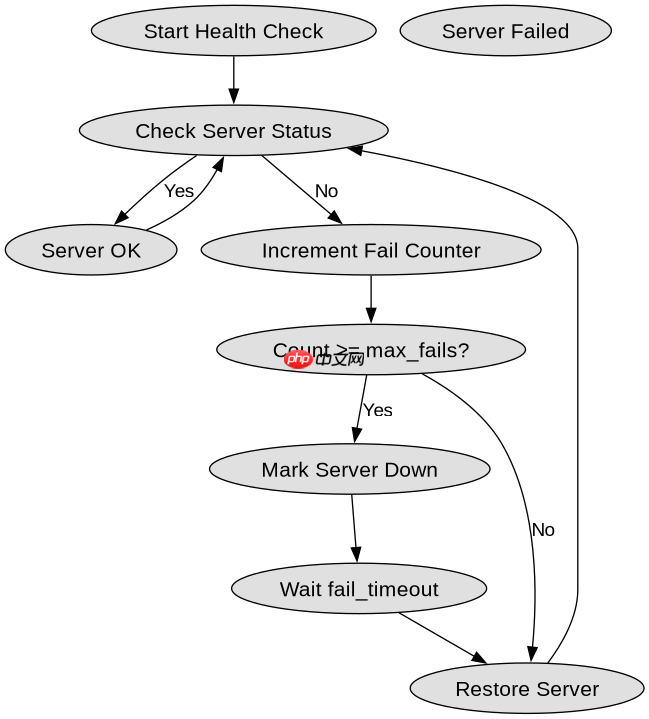
故障转移并非实时发生,而是依赖于健康检查机制。Nginx 通过 max_fails 和 fail_timeout 两个参数控制检测频率和判定标准。max_fails 定义了在一个 fail_timeout 时间段内,允许的最大失败次数。一旦超过该次数,Nginx 会将该服务器标记为不可用,并在 fail_timeout 指定的时间内不再向其发送请求。

upstream backend {
    server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.12:8080 backup;
}
在这个例子中,如果 192.168.1.10 在 30 秒内连续失败 3 次,Nginx 会在接下来的 30 秒内忽略该节点,并将流量转移到其他可用节点或备用节点。这种机制避免了因短暂网络抖动导致的频繁切换,同时也防止了将流量持续发送到已宕机的服务器。调整这些参数可以平衡故障检测的灵敏度和系统的稳定性。
基于 max_fails 阈值的流量重分配结果
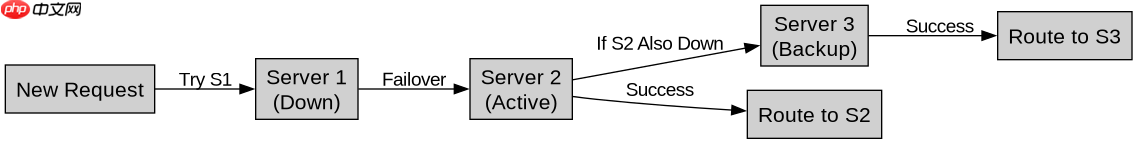
当 max_fails 阈值被触发时,Nginx 会立即停止向故障节点发送新请求,并将这些请求重新分配到剩余的健康节点。这一过程由 Nginx 内部的状态机管理,不会导致正在处理的连接中断,但新建立的连接会被导向其他服务器。
# 模拟客户端请求
# 假设 192.168.1.10 已失效
curl http://localhost/api/data
# 响应来自 192.168.1.11 或 192.168.1.12 (若前两者均失效)
在实际运行中,如果 192.168.1.10 和 192.168.1.11 同时失效,请求将自动流向 192.168.1.12。此时,192.168.1.12 的处理负载会增加,但其响应时间取决于其自身性能和当前并发量。Nginx 不会重试已失败的连接,而是直接选择下一个可用的上游服务器,确保请求的快速响应。



















