








在 nginx 中配置 ip_hash 实现多后端会话保持,需要在 upstream 块中指定 ip_hash 指令,并将多个后端服务器地址写入该块。nginx 会根据客户端 ip 的哈希值将请求固定分发到某一台后端服务器,从而确保同一 ip 的请求始终由同一实例处理。如果某个后端节点宕机,nginx 会自动将其剔除,待其恢复后重新加入集群。
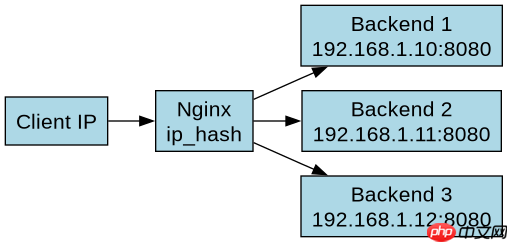
upstream 块中如何定义多个后端节点
要在 upstream 模块中使用 ip_hash,只需在块内添加指令并列出所有后端服务器的 server 行即可。每个 server 行指定一个后端服务的 IP 和端口。Nginx 会维护一个哈希表,根据客户端 IP 计算哈希值,然后映射到具体的后端节点。这种配置方式简单直接,适用于大多数基于 IP 的会话保持场景。
upstream backend {
    ip_hash;
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;
    server 192.168.1.12:8080;
}

server {
    listen 80;
    location / {
        proxy_pass http://backend;
    }
}
上述配置定义了三个后端节点:192.168.1.10、192.168.1.11 和 192.168.1.12。当客户端访问时,Nginx 会根据其 IP 地址计算哈希值,并将请求转发到对应的后端。例如,IP 为 10.0.0.1 的客户端可能始终被路由到 192.168.1.10,而 10.0.0.2 则可能路由到 192.168.1.11。这种机制确保了会话状态的持久性,前提是后端应用本身不依赖共享存储或外部会话管理。
如何处理后端节点故障与恢复
当使用 ip_hash 时,如果某个后端节点发生故障,Nginx 会自动将该节点标记为不可用,并将原本分配给该节点的请求转移到其他健康节点。这种转移是动态的,无需手动干预。然而,由于 ip_hash 是基于 IP 的哈希算法,节点数量的变化会导致哈希分布重新计算,可能引起部分用户的会话丢失。因此,在生产环境中,建议结合健康检查机制或使用更高级的会话保持策略,如基于 Cookie 的会话保持。

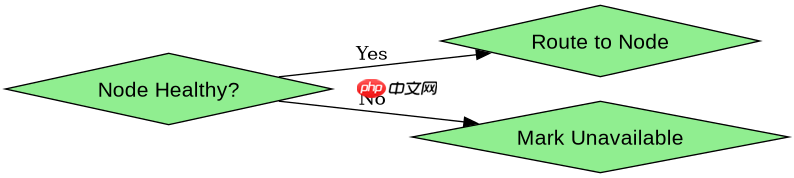
# 假设后端节点 192.168.1.11 故障
# Nginx 自动将原本路由到 192.168.1.11 的请求转移到 192.168.1.10 或 192.168.1.12
# 具体转移目标取决于新的哈希计算结果

# 验证节点状态
nginx -t
systemctl reload nginx
在上述代码中,我们展示了如何在 Nginx 配置中处理后端节点故障。当 192.168.1.11 故障时,Nginx 会自动调整哈希分布,将请求重定向到其他健康节点。需要注意的是,这种调整可能导致部分用户的会话状态丢失,因为他们的请求可能被路由到不同的后端。为了减少这种影响,可以考虑使用 sticky 模块或其他会话保持技术,或者在后端应用中实现会话同步机制。
ip_hash 在不同 IP 段下的行为差异
在使用 ip_hash 时,Nginx 默认基于完整的 IPv4 地址进行哈希计算。这意味着即使两个客户端位于同一个子网,只要它们的 IP 地址不同,就会被分配到不同的后端节点。这种行为在某些网络拓扑下可能导致负载不均。例如,如果大量用户来自同一个 /24 子网,它们可能会被均匀分散到所有后端节点,而不是集中在少数几个节点上。为了解决这个问题,可以使用 hash 指令配合自定义哈希函数,或者使用 sticky 模块基于 Cookie 进行会话保持。
# 示例:使用 hash 指令基于特定字段进行哈希
upstream backend {
    hash $remote_addr consistent;
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;
    server 192.168.1.12:8080;
}
在上述配置中,我们使用了 hash 指令并指定了 $remote_addr 作为哈希键,同时添加了 consistent 参数以减少节点变化时的哈希重分布。这种配置方式比默认的 ip_hash 更加灵活,可以根据实际需求调整哈希策略。此外,还可以结合 least_conn 或 weight 等负载均衡算法,进一步优化后端资源的利用率。


















