








使用 longadder 替代 synchronized 提升计数性能,核心做法是将共享的计数器变量从 long 类型替换为 java.util.concurrent.atomic.longadder,并将所有涉及计数的同步代码块或方法移除。这样做能利用分段累加机制分散热点锁竞争,在高并发场景下显著降低线程阻塞和上下文切换开销,从而提升吞吐量。

synchronized 在高频计数时的性能瓶颈是什么
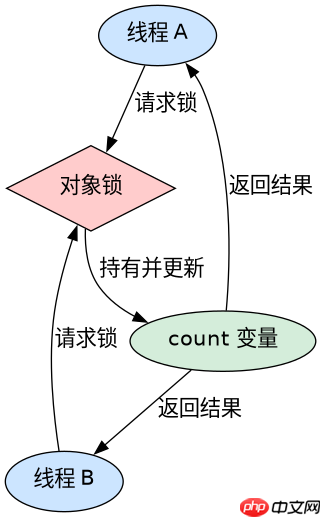
synchronized 在高频计数时主要面临锁竞争导致的串行化问题。当多个线程同时尝试执行 count++ 操作时,必须获取同一把对象锁,这会导致除一个线程外的其他线程全部进入等待状态。随着并发线程数增加,CPU 时间大量消耗在锁的获取与释放以及线程上下文的切换上,而非实际的业务逻辑处理中,导致整体计数速度随并发量增加而急剧下降。
public class CounterWithSync {
    private long count = 0;

    public synchronized void increment() {
        count++;
    }

    public long getCount() {
        return count;
    }
}
上述代码展示了典型的基于 synchronized 的计数器实现。每次调用 increment() 都会锁定当前实例,确保 count++ 操作的原子性。在低并发下表现尚可,但在高并发环境下,这种互斥机制会成为明显的性能瓶颈。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
LongAdder 的分段累加原理如何工作
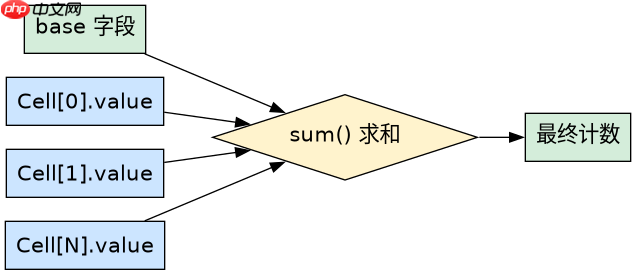
LongAdder 通过“空间换时间”的策略解决竞争问题。它内部维护了一个 Cell 数组,每个 Cell 包含一个 value 字段。当线程进行累加操作时,会根据线程 ID 哈希到特定的 Cell 上进行更新,只有当该 Cell 发生竞争时才会尝试 CAS 操作扩容或重试。最终结果通过累加所有 Cell 的值以及基础 base 值获得。这种设计使得大多数线程可以在不同的内存单元上并行操作,极大地减少了锁冲突。
import java.util.concurrent.atomic.LongAdder;

public class CounterWithLongAdder {
    private LongAdder count = new LongAdder();

    public void increment() {
        count.increment();
    }

    public long getCount() {
        return count.sum();
    }
}对比之前的实现,这里不再需要任何同步关键字。increment() 方法直接调用 LongAdder 的原子操作,底层自动处理分段累加逻辑。读取总数时调用 sum() 方法,该方法会遍历所有 Cell 并求和。虽然 sum() 操作本身是 O(N) 复杂度的,但在绝大多数计数场景中,读取频率远低于写入频率,因此整体性能得到显著提升。
LongAdder 在高并发下的具体表现如何
在实际的高并发测试中,LongAdder 的表现远优于 synchronized。假设有一组输入包含 100 个线程,每个线程执行 100,000 次累加操作。使用 synchronized 的实现可能会因为大量的线程等待而导致总耗时达到数秒甚至更久,而 LongAdder 由于避免了大部分锁竞争,通常能在几百毫秒内完成相同任务。此外,LongAdder 的内存占用略高于单个 long 变量,因为它需要维护 Cell 数组,但这种额外的内存开销在现代 JVM 中是可以接受的,且能有效换取计算性能的飞跃。



















