








php处理字符串中的emoji表情需要启用utf-8mb4编码并使用多字节函数,因为emoji占用4个字节而普通utf-8只占1至3个字节。使用mb_strlen、mb_substr和preg_match_all等函数时指定utf-8mb4字符集,可以正确计算长度、截取子串并匹配表情符号。若未正确设置,会导致截断乱码或计数错误。
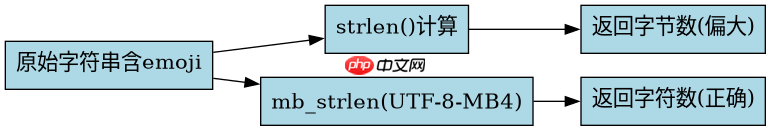
如何正确计算包含emoji的字符串长度
使用mb_strlen函数并指定第四个参数为'UTF-8-MB4'可得到正确的字符数。普通strlen会按字节计算导致数值偏大,而mb_strlen在UTF-8下会将4字节序列视为一个字符。确保数据库连接和字符串本身均为UTF-8-MB4编码,否则mb_strlen可能回退到默认行为或报错。
<?php
$str = "Hello ? World";
echo strlen($str); // 输出 15 (字节数)
echo mb_strlen($str, 'UTF-8-MB4'); // 输出 12 (字符数: H-e-l-l-o-空格-emoji-空格-W-o-r-l-d)
?>
上述代码中,strlen返回15是因为emoji占4个字节,而mb_strlen返回12是因为它识别出emoji为一个字符。实际开发中应始终使用mb_strlen并指定UTF-8-MB4以获取准确字符数。
立即学习“PHP免费学习笔记(深入)”;

使用官方Model Context Protocol PHP SDK将PHP应用程序功能暴露为MCP工具、资源和提示,用于代理工作流。
如何安全截取含emoji的子串
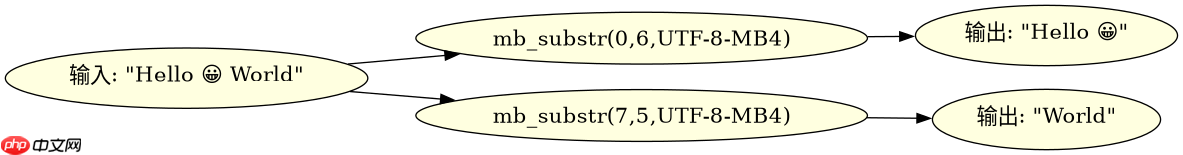
使用mb_substr函数并指定UTF-8-MB4字符集可避免截断emoji。若使用substr或mb_substr不指定正确字符集,可能在emoji中间截断产生乱码。需确保输入字符串已正确编码,且目标位置基于字符而非字节计算。
<?php
$str = "Hello ? World";
echo mb_substr($str, 0, 6, 'UTF-8-MB4'); // 输出 "Hello ?"
echo mb_substr($str, 7, 5, 'UTF-8-MB4'); // 输出 "World"
?>
示例中mb_substr从第0个字符开始截取6个字符,完整包含emoji;从第7个字符开始截取5个字符得到"World"。若误用substr,可能截断emoji导致显示异常。因此必须使用mb_substr并指定UTF-8-MB4。
如何检测并替换字符串中的emoji
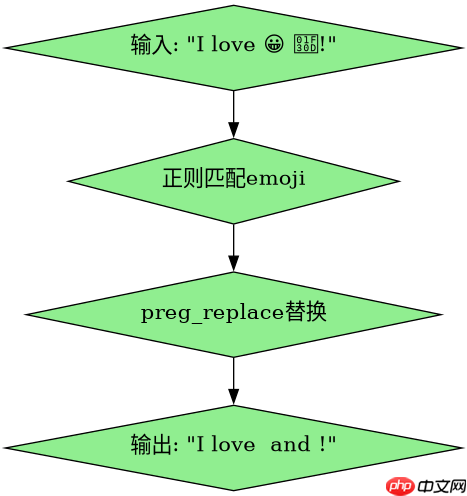
使用正则表达式配合PCRE_UTF8标志可匹配emoji,再用preg_replace进行替换。emoji范围广泛,常用Unicode块包括Emoticons、Miscellaneous Symbols and Pictorial Elements等。需构建涵盖常见emoji的正则模式,并在UTF-8-MB4环境下执行以确保匹配准确。
<?php
$str = "I love ? and ?!";
$pattern = '/[☀-➿-\u{1F000}-\u{1FFFF}]/u';
$cleaned = preg_replace($pattern, '', $str);
echo $cleaned; // 输出 "I love and !"
?>
该代码定义了一个覆盖主要emoji Unicode范围的正则表达式,使用'u'修饰符启用UTF-8模式。preg_replace将匹配的emoji替换为空字符串,得到不含表情的文本。注意正则需根据实际需求调整范围,避免遗漏或误伤其他符号。



















