








在 java 中避免嵌套循环的性能问题,核心策略是减少内层循环的执行次数,通常通过提前终止、使用哈希表(hashmap)将查找复杂度从 o(n) 降至 o(1),或者利用 stream api 的并行处理来实现。具体做法包括:在内层循环中加入条件判断以跳过无效迭代,或将数据预处理为 map 结构以便快速匹配。若数据量极大且计算独立,可考虑使用 parallelstream 进行并行化,但需注意线程开销与锁竞争。
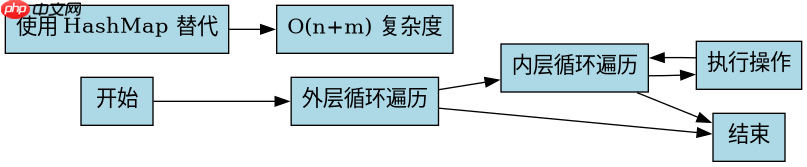
如何用 HashMap 替代双重循环进行数据匹配
使用 HashMap 可以将时间复杂度从 O(n*m) 降低到 O(n+m)。具体做法是将其中一个集合的数据存入 Map,键为匹配字段,值为对象引用或索引。遍历另一个集合时,直接通过 get() 方法查找匹配项,若存在则执行后续逻辑。这种方式避免了内层循环的逐一遍历,显著提升了性能。
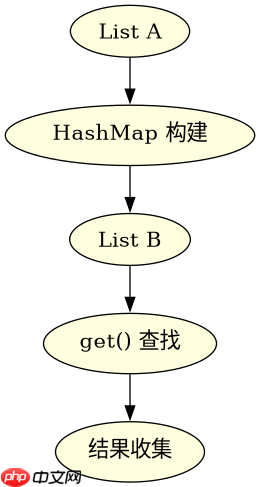
import java.util.*;

public class MatchExample {
    public static void main(String[] args) {
        List<String> listA = Arrays.asList("a", "b", "c");
        List<String> listB = Arrays.asList("b", "d", "e");

        // 构建 Map: key=元素, value=是否匹配
        Map<String, Boolean> matchMap = new HashMap<>();
        for (String s : listA) {
            matchMap.put(s, true);
        }

        // 遍历 listB 并匹配
        List<String> result = new ArrayList<>();
        for (String s : listB) {
            if (matchMap.getOrDefault(s, false)) {
                result.add(s);
            }
        }
        System.out.println(result); // [b]
    }
}
如何优化嵌套循环中的重复计算
当嵌套循环中存在重复计算时,应将不变的计算提取到外层循环之前。例如,若内层循环依赖某个固定值,应预先计算该值并缓存。此外,可使用局部变量缓存数组长度或集合大小,避免每次迭代都调用 length 或 size() 方法。这些微小优化在高频率循环中能累积成显著的性能提升。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
立即学习“Java免费学习笔记(深入)”;
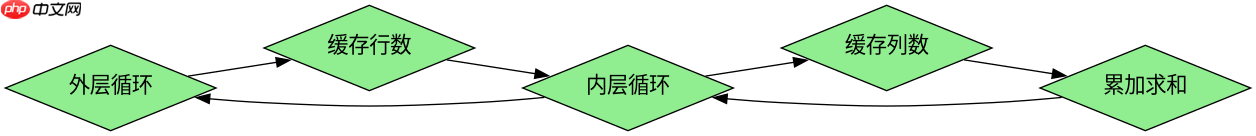
public class OptimizationExample {
    public static void main(String[] args) {
        int[][] matrix = {{1, 2}, {3, 4}};
        int sum = 0;

        // 优化前:每次访问 matrix.length 和 matrix[i].length
        // for (int i = 0; i < matrix.length; i++) {
        //     for (int j = 0; j < matrix[i].length; j++) {
        //         sum += matrix[i][j];
        //     }
        // }

        // 优化后:缓存长度
        int rows = matrix.length;
        for (int i = 0; i < rows; i++) {
            int cols = matrix[i].length;
            for (int j = 0; j < cols; j++) {
                sum += matrix[i][j];
            }
        }
        System.out.println(sum); // 10
    }
}
当输入为空列表时嵌套循环会抛出异常吗
不会。Java 的嵌套循环在处理空列表时不会抛出异常,因为循环条件会在首次检查时即为 false,从而跳过整个循环体。例如,若外层列表为空,内层循环根本不会执行;若内层列表为空,内层循环同样被跳过。因此,无需额外添加空值检查来防止异常,但建议保留空值判断以提升代码可读性和健壮性。



















