








在oracle sql中,使用 row_number() 进行高效分页查询的核心做法是:利用窗口函数生成行号,并通过外层查询过滤目标区间。具体实现时,通常采用“三层嵌套”结构(或 oracle 12c+ 的 offset ... fetch 语法),内层查询计算 row_number() over (order by ...) 得到全局序号,中层查询筛选出介于 (page-1)*size + 1 和 page*size 之间的行号,最外层返回实际数据。这样做能确保数据库只扫描必要的索引范围并返回精确数量的记录,避免全表扫描或低效的伪列过滤。

传统三层嵌套分页的具体写法与执行逻辑
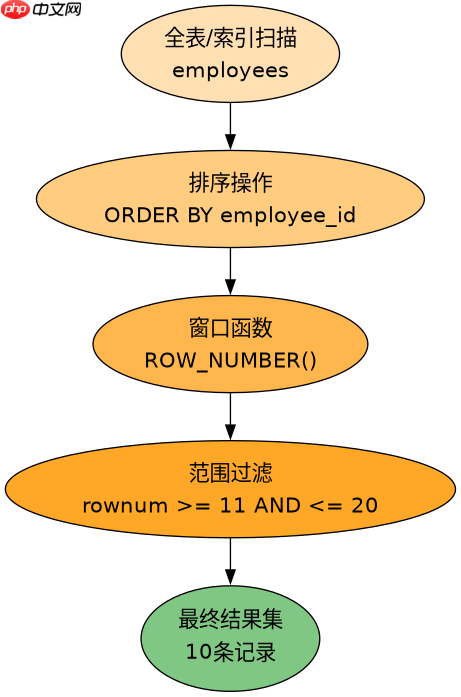
对于 Oracle 11g 及更早版本,标准的高效分页模式是使用子查询包裹 ROW_NUMBER()。假设我们需要查询 employees 表的第 2 页,每页 10 条记录,按 employee_id 排序。首先在内层视图 inner_query 中为所有行分配连续的行号;其次在中层视图 outer_query 中通过 BETWEEN 条件锁定第 11 到 20 行的行号范围;最后在外层查询中选择这些行的实际字段。这种写法强制优化器先完成排序和编号,再执行范围过滤,配合 employee_id 上的索引,可以显著减少 I/O 开销。
SELECT * FROM ( SELECT inner_query.*, ROWNUM rnum FROM ( SELECT employee_id, first_name, last_name, salary FROM employees ORDER BY employee_id ) inner_query WHERE ROWNUM <= :end_row ) outer_query WHERE rnum >= :start_row;
上述代码展示了经典的 Oracle 分页模板。其中 :start_row 设为 11,:end_row 设为 20。注意,直接在外层使用 ROWNUM 别名过滤会导致逻辑错误,因为 ROWNUM 是在行被选出后才分配的。因此必须通过两层子查询:第一层排序并限制最大行数,第二层从结果中截取最小行数。若需处理空结果集,该查询自然返回空集,不会报错。

Oracle 12c+ 现代分页语法的对比与优势
从 Oracle 12c 开始,SQL 标准引入了 FETCH FIRST ... ROWS ONLY 和 OFFSET ... ROWS FETCH NEXT 语法,这比传统的 ROW_NUMBER() 嵌套更简洁且性能相当。虽然题目要求使用 ROW_NUMBER(),但理解现代语法有助于确认底层行为。在现代语法中,数据库优化器会自动将 OFFSET 转换为高效的游标定位或索引扫描,无需手动编写多层子查询。然而,当需要获取总行数或复杂排序键时,ROW_NUMBER() 依然不可替代。例如,在需要同时返回当前页数据和总记录数的场景中,必须保留窗口函数结构。
-- Oracle 12c+ 等效写法(不使用ROW_NUMBER,仅作对比) SELECT employee_id, first_name, last_name, salary FROM employees ORDER BY employee_id OFFSET 10 ROWS FETCH NEXT 10 ROWS ONLY;
对比可见,现代语法省略了中间层的行号过滤逻辑。但在实际开发中,若业务逻辑依赖行号进行后续处理(如前端高亮特定行),则仍需使用 ROW_NUMBER()。两种方法在相同索引条件下,执行计划中的索引访问路径一致,主要差异在于 SQL 解析阶段的复杂度。建议在新项目中优先使用 12c+ 语法,除非存在兼容旧版数据库的需求。
基于ORDER BY缺失导致的行号不稳定问题
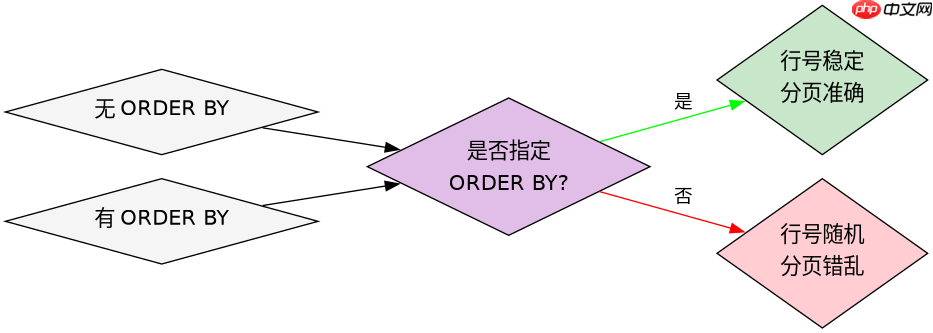
在使用 ROW_NUMBER() 时,一个常见的陷阱是忽略 OVER() 子句中的 ORDER BY 部分。如果未指定排序列,Oracle 会返回任意顺序的行号,导致分页结果在不同执行时间不一致。例如,若查询语句写为 ROW_NUMBER() OVER (),则第 2 页的数据可能包含第 1 页已出现的记录,或者遗漏某些记录。这是因为窗口函数在没有明确排序依据时,依赖于内部存储顺序或并行执行的随机性。为确保分页确定性,必须在 OVER() 中显式声明唯一或复合排序键,如 ORDER BY employee_id, hire_date。即使 employee_id 是主键,显式写出也能提升代码可读性和优化器预测准确性。此外,若排序列包含 NULL 值,需考虑 NULLS FIRST 或 NULLS LAST 以固定边界行为。




















