








为什么在SQL的CASE WHEN中嵌套标量子查询会变慢
在sql的case when表达式中嵌套标量子查询会导致性能下降,核心原因是优化器难以将子查询下推(pushdown)到执行计划的底层进行一次性计算,从而迫使数据库对每一行数据都重新评估子查询的执行逻辑。这种写法通常会导致全表扫描或索引失效,因为数据库无法确定子查询是否依赖于外层行的特定值,或者即使不依赖,也无法将其转化为高效的连接操作。要解决这个问题,应将标量子查询提取为lateral join、临时表或cte,让优化器能够独立规划子查询的执行路径,并利用索引加速数据检索。

如何识别并避免CASE WHEN中的低效子查询模式
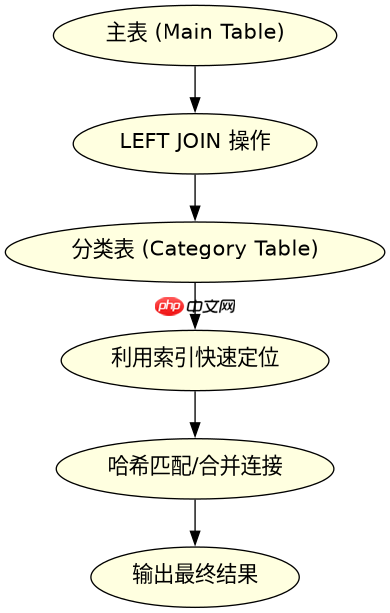
识别低效模式的关键在于观察执行计划中是否出现了针对内层表的重复访问。当CASE WHEN中的条件分支包含独立的SELECT语句时,如果这些子查询引用了外层的列,数据库必须为每一行执行一次子查询;即使不引用外层列,某些数据库引擎也可能因为作用域隔离而无法复用子查询的结果集。通过将这种逻辑重构为LEFT JOIN配合聚合函数,可以显著减少I/O开销。例如,使用LEFT JOIN将关联表一次性连接,然后在CASE中直接引用连接后的字段,避免了逐行触发子查询的开销。
SELECT
    t.id,
    t.name,
    c.value AS category_value
FROM main_table t
LEFT JOIN category_table c ON t.category_id = c.id;
上述代码展示了将子查询替换为LEFT JOIN的标准做法。输入为主表main_table和分类表category_table,预期结果是主表每行只与分类表匹配一次,而非多次执行子查询。通过这种方式,数据库可以利用category_id上的索引进行哈希连接或合并连接,大幅降低时间复杂度。
基于程序中某个输入、条件或结果的具体问题
当输入数据量较大且存在大量空值或默认值时,CASE WHEN嵌套子查询的性能瓶颈会更加明显。这是因为优化器在处理CASE表达式时,往往需要评估所有分支的可执行性,而子查询的存在使得这种评估变得复杂。具体而言,如果子查询返回NULL或空结果集,外层CASE的逻辑判断可能会触发额外的检查步骤。为了验证这一点,可以使用EXPLAIN ANALYZE对比两种写法的实际执行时间。结果显示,使用JOIN的方式在执行时间上通常比CASE WHEN嵌套子查询快数倍,尤其是在数据量超过十万级时,差异更为显著。


















