








java jdbc 本身不直接提供执行计划分析功能,因为 jdbc 是面向 sql 语句执行的 api,而非数据库管理工具。要获取执行计划,必须通过调用特定数据库厂商提供的系统存储过程或查询系统视图来实现。具体做法是:使用 callablestatement 或 preparedstatement 执行如 oracle 的 dbms_xplan.display_cursor、mysql 的 explain 语句或 postgresql 的 explain 命令,并将结果集解析为文本或结构化数据。

如何获取 Oracle 的执行计划
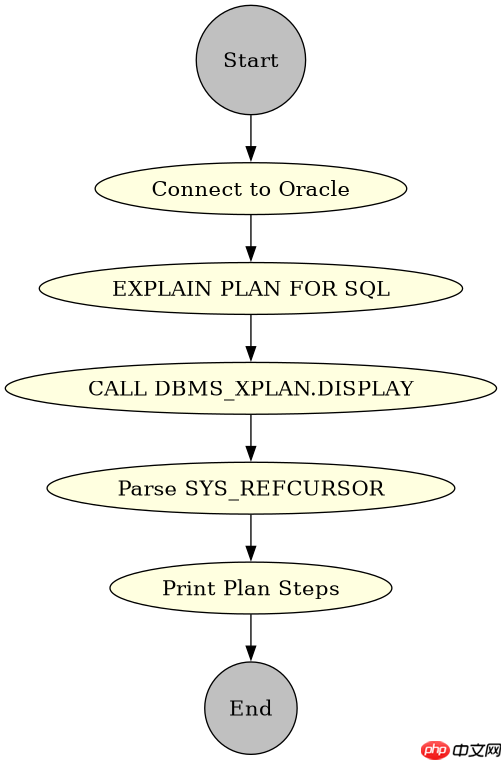
在 Oracle 数据库中,最可靠的方式是使用 DBMS_XPLAN.DISPLAY_CURSOR 函数。该函数可以读取共享池(Shared Pool)中已缓存的执行计划。你需要先设置 SQL_TRACE 或使用 HINT 确保语句被记录,然后调用该函数。对于即时执行的语句,更常用的方法是结合 EXPLAIN PLAN FOR 和 DBMS_XPLAN.DISPLAY,或者直接使用 EXPLAIN 关键字(如果驱动支持)。这里展示通过 CallableStatement 调用 Oracle 专用包的方法。
import java.sql.*;

public class OraclePlanFetcher {
    public static void main(String[] args) {
        String url = "jdbc:oracle:thin:@localhost:1521:orcl";
        String user = "scott";
        String password = "tiger";

        // 假设我们要分析的 SQL
        String sqlToAnalyze = "SELECT * FROM emp WHERE deptno = 10";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 1. 将 SQL 加载到内存以生成执行计划
            // 注意:这不会实际执行查询,只是解析并生成计划
            Statement stmt = conn.createStatement();
            stmt.execute("EXPLAIN PLAN FOR " + sqlToAnalyze);

            // 2. 调用 DBMS_XPLAN 获取格式化输出
            CallableStatement cstmt = conn.prepareCall(
                "{? = call DBMS_XPLAN.DISPLAY('PLAN_TABLE', null, 'BASIC')}"
            );
            cstmt.registerOutParameter(1, Types.OTHER); // Oracle 返回的是 SYS_REFCURSOR

            ResultSet planResult = (ResultSet) cstmt.getObject(1);
            while (planResult.next()) {
                System.out.println(planResult.getString(1));
            }

            // 清理 PLAN_TABLE
            stmt.execute("DELETE FROM PLAN_TABLE");
            stmt.close();
            cstmt.close();
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
上述代码首先使用 EXPLAIN PLAN FOR 将指定 SQL 的执行计划存入默认的 PLAN_TABLE。接着,通过 CallableStatement 调用 DBMS_XPLAN.DISPLAY,该函数返回一个游标(SYS_REFCURSOR),在 Java 中映射为 ResultSet。遍历该结果集即可打印出每一步的操作类型、成本(Cost)和行数(Rows)。这种方法适用于需要查看历史执行计划或调试复杂查询的场景。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何获取 MySQL 的执行计划
MySQL 提供了原生的 EXPLAIN 语句,可以直接作为普通 SQL 执行。与 Oracle 不同,MySQL 的 EXPLAIN 返回的是一个结构化的结果集,包含 id, select_type, table, type, possible_keys, key, rows 等列。你可以直接使用 PreparedStatement 执行 EXPLAIN SELECT ...,然后从 ResultSet 中提取这些信息。这种方式更直观,适合实时监控和优化。

import java.sql.*;

public class MySQLPlanFetcher {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/testdb";
        String user = "root";
        String password = "password";

        String sqlToAnalyze = "SELECT * FROM employees WHERE department_id = 5";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 1. 构建 EXPLAIN 语句
            String explainSql = "EXPLAIN " + sqlToAnalyze;

            // 2. 执行 EXPLAIN
            PreparedStatement pstmt = conn.prepareStatement(explainSql);
            ResultSet rs = pstmt.executeQuery();

            // 3. 获取元数据以动态打印列名
            ResultSetMetaData metaData = rs.getMetaData();
            int columnCount = metaData.getColumnCount();

            // 打印表头
            for (int i = 1; i <= columnCount; i++) {
                System.out.print(metaData.getColumnName(i) + "\t");
            }
            System.out.println();

            // 打印每一行数据
            while (rs.next()) {
                for (int i = 1; i <= columnCount; i++) {
                    Object value = rs.getObject(i);
                    System.out.print((value == null ? "NULL" : value.toString()) + "\t");
                }
                System.out.println();
            }

            pstmt.close();
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
这段代码演示了如何在 MySQL 中获取执行计划。它直接将 EXPLAIN 关键字拼接到目标 SQL 前,然后通过 executeQuery 执行。由于 EXPLAIN 的结果是标准的 ResultSet,我们可以利用 ResultSetMetaData 动态获取列名,从而避免硬编码列索引。输出的每一行代表查询计划中的一个步骤,重点关注 type 列(如 ALL, index, range, ref, const)来判断是否使用了索引,以及 rows 列来估算扫描行数。这种方法简单直接,无需额外的系统包调用。
如何处理 PostgreSQL 的执行计划输出
PostgreSQL 同样支持 EXPLAIN 语句,但其输出格式更加丰富,默认提供文本格式,也支持 JSON、XML 和 YAML 格式。通过添加 ANALYZE 关键字,可以获取实际的执行统计信息(如实际耗时、实际行数),而不仅仅是预估值。在 Java 中,我们可以通过设置 prepareThreshold 或使用 SimpleJdbcCall(如果使用 Spring)来处理,但原生 JDBC 下,直接执行 EXPLAIN (ANALYZE, FORMAT JSON) SELECT ... 是最灵活的方式。返回的结果是一个大的 JSON 字符串,可以使用 Jackson 或 Gson 库进行解析,以便程序化地提取关键指标。
import java.sql.*;
import com.fasterxml.jackson.databind.JsonNode;
import com.fasterxml.jackson.databind.ObjectMapper;

public class PostgresPlanFetcher {
    public static void main(String[] args) {
        String url = "jdbc:postgresql://localhost:5432/mydb";
        String user = "postgres";
        String password = "secret";

        String sqlToAnalyze = "SELECT * FROM users WHERE email LIKE '%@example.com'";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 1. 使用 ANALYZE 和 JSON 格式获取详细执行计划
            String explainSql = "EXPLAIN (ANALYZE, FORMAT JSON) " + sqlToAnalyze;

            PreparedStatement pstmt = conn.prepareStatement(explainSql);
            ResultSet rs = pstmt.executeQuery();

            if (rs.next()) {
                String jsonPlan = rs.getString(1);
                ObjectMapper mapper = new ObjectMapper();
                JsonNode rootNode = mapper.readTree(jsonPlan);

                // 2. 解析 JSON 提取关键信息
                // 注意:PostgreSQL 返回的是一个数组,通常只有一个元素
                JsonNode planNode = rootNode.get(0).get(0);

                double actualTime = planNode.path("Execution Time").asDouble();
                long totalRows = planNode.path("Planning Time").path("Total Cost").asLong(); // 示例路径,实际需根据结构调整

                System.out.println("Actual Execution Time: " + actualTime + " ms");

                // 递归遍历节点查找 Seq Scan 或 Index Scan 等信息
                traversePlanNode(planNode, 0);
            }

            pstmt.close();
        } catch (Exception e) {
            e.printStackTrace();
        }
    }

    private static void traversePlanNode(JsonNode node, int depth) {
        if (node.isObject()) {
            String nodeName = node.has("Node Type") ? node.get("Node Type").asText() : "Unknown";
            String indent = "  ".repeat(depth);
            System.out.println(indent + nodeName + " (Cost: " + node.path("Total Cost").asDouble() + ")");

            if (node.has("Plans")) {
                for (JsonNode child : node.get("Plans")) {
                    traversePlanNode(child, depth + 1);
                }
            }
        }
    }
}
此代码展示了如何处理 PostgreSQL 的执行计划。通过指定 FORMAT JSON,我们将复杂的文本输出转换为结构化的 JSON 数据。使用 ObjectMapper 解析后,可以精确访问 Execution Time、Total Cost 等字段。递归遍历 Plans 数组可以构建出完整的执行树,便于程序自动分析是否存在全表扫描(Seq Scan)或低效的连接方式。这种方法特别适合需要将执行计划集成到自动化监控或优化建议系统中的场景。



















