








在sql中无法直接通过单行聚合函数同时提取min或max对应的多列属性,因为标准sql的聚合操作是逐列独立计算的。要实现这一目标,必须使用子查询先找出极值,再通过连接条件匹配原始记录,或者使用窗口函数配合排序和过滤来定位包含所有所需属性的完整行。

如何使用子查询关联获取极值所在行的其他字段
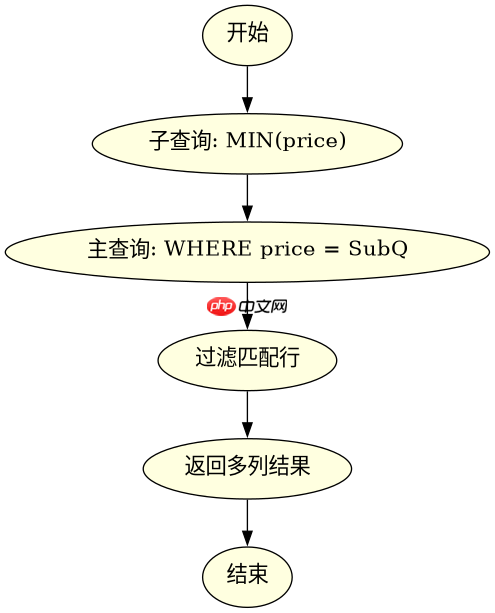
该方法的核心逻辑是先计算目标列的最小值,然后将原表与这个最小值进行连接,从而筛选出拥有该最小值的整行数据。假设有一张名为 sales 的表,包含 product_id、price 和 discount 三列,我们想要找到价格最低的那条记录及其对应的折扣率。首先执行一个子查询获取最低价格,然后在主查询中通过 WHERE price = (subquery) 进行过滤。这种方法简单直观,适用于大多数支持子查询的数据库系统。需要注意的是,如果存在多个相同极值的记录,此方法会返回所有匹配的行。
SELECT product_id, price, discount
FROM sales
WHERE price = (SELECT MIN(price) FROM sales);
运行上述代码后,结果将返回 price 列值为最小值的所有行,包括对应的 product_id 和 discount。例如,若最低价格为 10.0,且有两件商品价格为 10.0,则这两条记录的完整信息都会被返回。这解决了需要同时获取极值及其关联属性的问题。
如何使用窗口函数处理并列极值并指定优先级
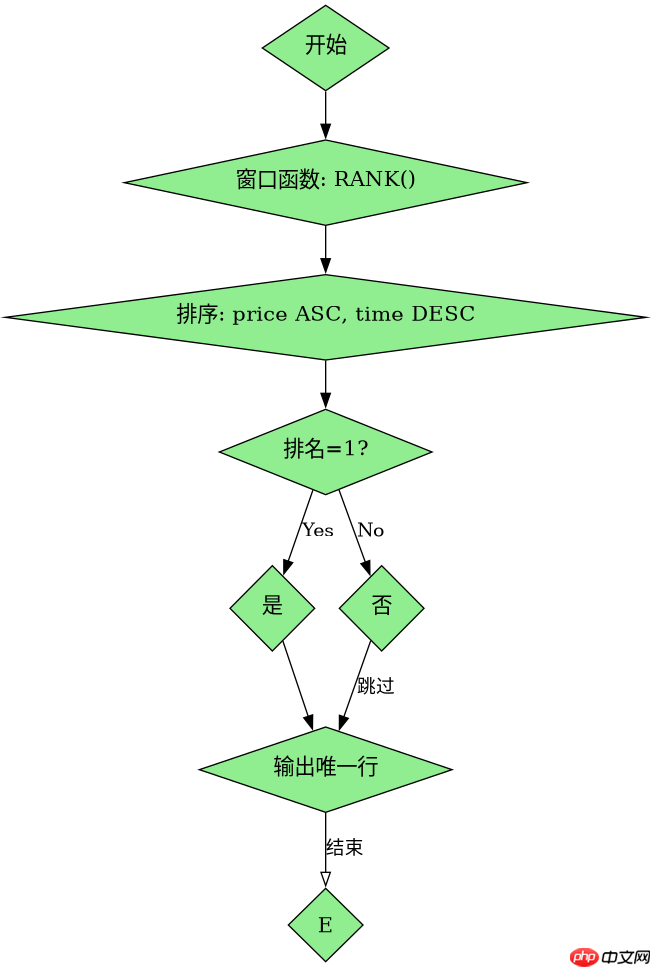
当需要更精细地控制结果,例如在多个极值记录中只选择一条,或者按特定顺序(如时间先后)确定唯一记录时,窗口函数 RANK() 或 DENSE_RANK() 是更好的选择。我们可以基于 price 列进行升序排列,并为每行分配一个排名。然后在外层查询中过滤出排名为 1 的记录。这种方式允许我们在极值相同的情况下,引入第二排序键(如 created_at)来决定最终输出哪一行,避免了子查询可能带来的性能瓶颈或多行返回的不确定性。
SELECT product_id, price, discount
FROM (
    SELECT product_id, price, discount,
           RANK() OVER (ORDER BY price ASC, created_at DESC) as rnk
    FROM sales
) ranked_sales
WHERE rnk = 1;
执行该查询后,系统将首先按 price 升序排序,若价格相同则按 created_at 降序排序。排名为 1 的记录即为价格最低且创建时间最晚的那一条。结果集中仅包含这一条完整记录,确保了输出的唯一性和确定性。这种方法特别适用于需要“最新”或“最早”极值记录的复杂业务场景。
当极值记录不存在时如何处理空值情况
在上述两种方法中,如果表为空或查询条件导致无匹配记录,结果集将为空。在实际应用中,可能需要对这种情况进行特殊处理,例如返回默认值或使用 COALESCE 函数。虽然SQL本身不直接提供“极值对应行不存在时的默认填充”功能,但可以通过外层应用 LEFT JOIN 或 UNION ALL 结合常量插入来实现。例如,可以先尝试获取极值行,若结果为空,则插入一条包含默认 discount 值的记录。这种处理方式增强了程序的健壮性,确保前端或下游系统始终能接收到结构一致的数据,即使底层数据缺失。
















