








在sql中按中文拼音或字符集顺序排序,核心在于设置正确的排序规则(collation)。具体做法是查询时显式指定如 collate chinese_prc_ci_as 这样的参数,或者在建表/库时设定默认规则。这样做会让数据库引擎根据指定的语言规则对字符串进行比较和排序,从而得到符合预期的中文结果。如果未指定,系统可能使用二进制排序,导致中文乱序。
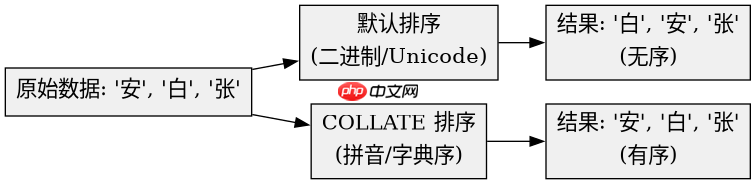
COLLATE 关键字如何改变排序行为
通过 COLLATE 子句可以临时覆盖默认的排序规则。例如,使用 ORDER BY name COLLATE Chinese_PRC_CI_AS 会按拼音排序,而 ORDER BY name COLLATE Latin1_General_BIN 则按字节值排序。这种语法适用于大多数主流关系型数据库,如 SQL Server 和 MySQL(部分版本)。
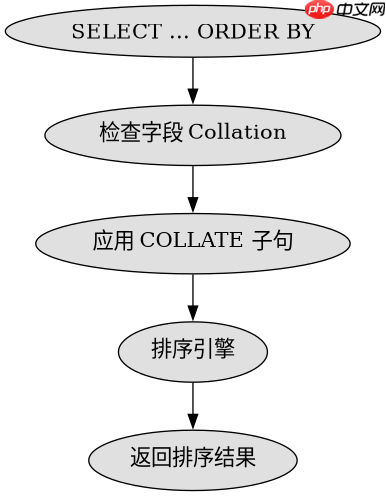
SELECT name FROM users ORDER BY name COLLATE Chinese_PRC_CI_AS;
上述语句在 SQL Server 中执行时,会根据简体中文的拼音规则对 name 字段进行排序。如果字段本身没有定义特定的 Collation,该子句会强制应用指定的规则。结果是“安”排在“白”之前,而不是基于 Unicode 码点。
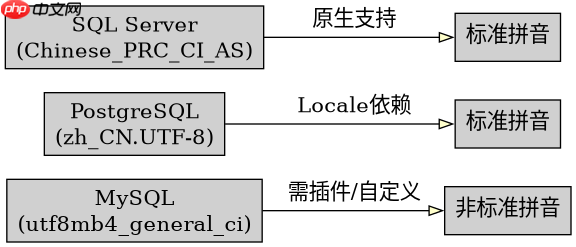
不同数据库的默认排序规则差异
MySQL 和 PostgreSQL 等数据库在处理中文排序时有不同的默认机制。MySQL 5.7 及更早版本通常使用 utf8_general_ci,这可能不是严格的拼音排序。PostgreSQL 则需要安装 zh_CN locale 或使用 citext 扩展配合特定排序规则。理解这些差异有助于避免跨平台迁移时的排序错误。
-- MySQL 示例
SELECT name FROM users ORDER BY name COLLATE utf8mb4_bin;
在 MySQL 中,使用 utf8mb4_bin 会按字节值排序,这通常不符合中文习惯。若要实现拼音排序,可能需要借助第三方插件或自定义函数,因为原生支持不如 SQL Server 直接。建议在应用层处理复杂排序需求,或在数据库层面统一使用支持拼音的 Collation。
当输入包含多音字时排序结果如何确定
当输入包含多音字(如“重庆”)时,排序结果取决于具体的 Collation 实现。大多数标准 Collation 基于字典序,即固定读音。例如,“重庆”中的“重”在拼音排序中通常固定为 chong。如果数据中存在歧义,可能需要预处理数据或使用自定义排序映射表来确保准确性。


















