








在sql中通过覆写索引避免group by额外排序,核心做法是创建复合索引时,将group by涉及的列作为索引的前导列(leading columns),并确保这些列的顺序与查询中的分组顺序完全一致。这样数据库引擎可以直接利用索引的有序性进行分组聚合,从而跳过额外的文件排序(filesort)步骤。例如,若查询为 select status, count(*) from orders group by status 则应建立 (status) 或 (status, other_col) 的索引。
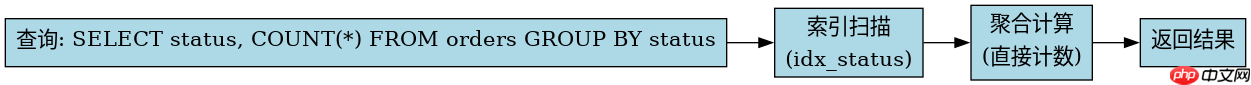
为什么GROUP BY会导致额外排序
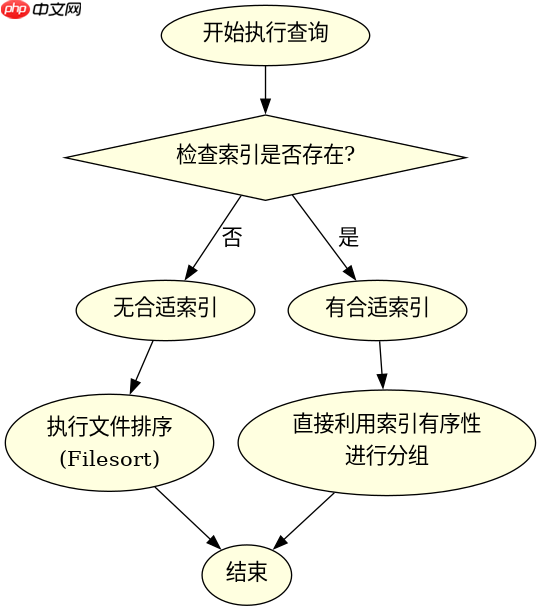
当执行包含 GROUP BY 的查询时,如果数据库无法直接利用现有数据的有序性,它必须先将所有匹配的行提取出来,然后在内存或磁盘上进行排序,以便将相同的键值聚集在一起进行聚合计算。这个过程通常被称为“文件排序”(Filesort)。即使数据量不大,这种排序操作也会消耗大量的CPU和I/O资源,成为性能瓶颈。如果没有合适的索引支持,或者索引列的顺序与分组列不匹配,优化器就会选择这种低效的执行计划。
CREATE INDEX idx_status ON orders (status);
上述代码创建了一个基于 orders 表 status 列的索引。当执行 SELECT status, COUNT(*) FROM orders GROUP BY status 时,由于 status 是索引的前导列,索引本身已经是有序的。优化器可以扫描索引树,直接按顺序处理每个唯一的 status 值并计数,无需任何额外的排序操作。这显著提升了查询效率,尤其是在数据量大且 status 区分度不高时。
多列GROUP BY的索引匹配策略
对于涉及多个列的 GROUP BY 子句,如 GROUP BY col1, col2,索引的设计必须严格遵循最左前缀原则。也就是说,索引的第一列必须是 col1,第二列必须是 col2。如果索引顺序颠倒,例如建立了 (col2, col1) 的索引,数据库将无法直接利用该索引进行两列的联合分组,仍然会触发额外的排序操作。此外,如果查询中还包含 ORDER BY 子句,且其排序顺序与 GROUP BY 一致,那么同一个索引可以同时满足分组和排序的需求,彻底消除排序开销。

CREATE INDEX idx_status_date ON orders (status, order_date);
此代码创建了覆盖 status 和 order_date 的复合索引。当执行 SELECT status, order_date, COUNT(*) FROM orders GROUP BY status, order_date 时,索引首先按 status 排序,在 status 相同的情况下再按 order_date 排序。这完美契合了 GROUP BY status, order_date 的逻辑,使得数据库可以直接遍历索引完成分组聚合,避免了任何中间排序步骤。
基于索引前导列的具体问题
在实际应用中,一个常见的问题是:如果 GROUP BY 的列不是索引的最左前导列,是否还能避免排序?答案是否定的。例如,若建立了 (status, user_id) 的索引,但查询仅对 user_id 进行 GROUP BY,数据库无法利用该索引的有序性来直接分组 user_id,因为索引主要是按 status 组织的。此时,数据库可能需要回表扫描或使用临时表进行排序。因此,确保分组列位于索引的最左侧是避免额外排序的关键条件。
















