








查询某个字段值出现频率最高的初始样本,核心思路是先通过子查询或窗口函数找出最高频次,再筛选出对应记录。具体做法是使用 `group by` 配合 `order by count(*) desc limit 1` 获取最高频值,或者使用 `rank()` 窗口函数对原始数据进行排名,最后提取排名为1的记录。这样做能直接得到出现次数最多的那一行或多行原始数据,若存在并列最高频,则返回所有并列项。

如何获取单一最高频记录的完整行数据
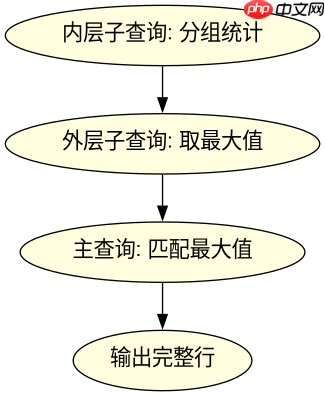
要获取单一最高频记录的完整行数据,可以使用子查询先计算出最大计数值,然后在主查询中匹配该计数值。这种方法逻辑简单,适用于大多数SQL方言。具体步骤是:先按目标字段分组统计数量,排序取最大值;然后在外层查询中过滤出计数等于该最大值的记录。如果希望结果唯一,可以结合 `LIMIT 1` 或添加其他去重条件。
SELECT * FROM table_name
WHERE count_col = (
    SELECT MAX(cnt)
    FROM (
        SELECT target_field, COUNT(*) as cnt
        FROM table_name
        GROUP BY target_field
    ) AS subquery
);
上述代码首先在内层子查询中对 `target_field` 进行分组并计算每组的数量 `cnt`。接着,外层子查询从这些计数值中选出最大值 `MAX(cnt)`。最后,主查询筛选出 `count_col`(即实际计数字段)等于该最大值的原始行。假设输入表中有三行数据,`target_field` 分别为 'A', 'B', 'A',则 'A' 的计数为2,'B' 的计数为1。最大值为2,因此查询将返回所有 `target_field` 为 'A' 的原始行。若表中只有一行 'A',则返回该行;若有两行 'A',则返回这两行。此方法确保返回的是完整的原始记录,而不仅仅是聚合后的统计值。
如何处理并列最高频且保留所有原始样本
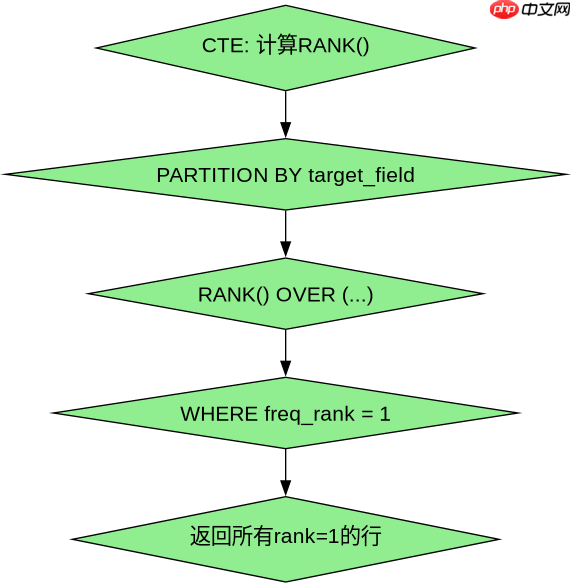
当存在多个值具有相同的最高频次时,需要保留所有并列的原始样本。此时推荐使用窗口函数 `RANK()` 或 `DENSE_RANK()`。`RANK()` 会在并列情况下跳过后续排名,而 `DENSE_RANK()` 不会跳过。对于“保留所有最高频样本”的需求,两者在顶层排名为1时效果一致。具体做法是为每一行数据计算其所属分组的排名,然后筛选排名为1的行。这种方法避免了子查询的性能开销,且在支持窗口函数的数据库(如MySQL 8.0+, PostgreSQL, SQL Server)中效率更高。
WITH RankedData AS (
    SELECT *,
           RANK() OVER (PARTITION BY 1 ORDER BY COUNT(target_field) OVER (PARTITION BY target_field) DESC) as freq_rank
    FROM table_name
)
SELECT * FROM RankedData
WHERE freq_rank = 1;
上述代码使用CTE(公共表表达式)和窗口函数。首先,`COUNT(target_field) OVER (PARTITION BY target_field)` 计算每行所属分组的总计数。然后,`RANK() OVER (... ORDER BY ... DESC)` 根据这个计数值对所有行进行降序排名。由于 `PARTITION BY 1`,所有行参与同一排名序列,计数最高的组获得 rank 1。最后,外层查询筛选 `freq_rank = 1` 的行。假设输入表有三行,`target_field` 为 'A', 'B', 'A'。第一行 'A' 的计数为2,第二行 'B' 的计数为1,第三行 'A' 的计数为2。排名时,两个 'A' 行因计数2并列第1,'B' 行计数1排第3。因此,查询返回两行 'A' 的原始数据。若输入为 'A', 'B', 'C',三者计数均为1,则全部返回。此方法准确保留了所有最高频的原始样本,无遗漏。
当输入字段包含NULL值时查询结果会怎样
当输入字段包含NULL值时,SQL的 `GROUP BY` 会将所有NULL值视为同一组,并统计其出现次数。因此,如果NULL值的出现频率最高,查询结果将返回所有 `target_field` 为NULL的原始行。这是标准SQL的行为,符合预期。具体验证方法是:构造包含NULL值的测试数据,执行前述任一查询,观察返回结果是否包含NULL行及其数量是否正确。例如,若表中三行分别为 'A', NULL, NULL,则NULL计数为2,'A' 计数为1,最高频为NULL,查询返回两行NULL记录。


















