








在sql中处理脏数据的核心策略是利用多层子查询将“清洗”与“业务逻辑”解耦,通过内层子查询完成去重、格式标准化和异常值过滤,外层查询直接消费干净的数据集。具体做法是先在内层子查询中使用正则表达式或字符串函数修复字段格式(如去除空格、统一日期),再结合窗口函数或聚合操作剔除重复记录,最后在外层查询中对清洗后的数据进行统计或关联。这种分层结构能避免长链式嵌套导致的可读性崩溃,同时确保脏数据的修正逻辑集中且可复用。

如何识别并剔除包含非法字符的脏数据
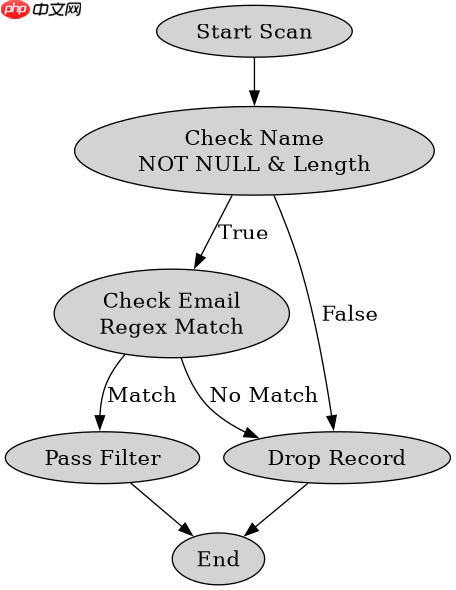
利用正则表达式配合`REGEXP_LIKE`或`LIKE`操作符,可以在子查询中精准定位并隔离脏数据。通过设置严格的匹配条件,内层查询只保留符合规范的数据行,从而在源头切断脏数据的流入。
SELECT id, name, email
FROM (
    SELECT
        id,
        TRIM(name) AS name,
        LOWER(email) AS email
    FROM raw_users
    WHERE name IS NOT NULL
      AND REGEXP_LIKE(email, '^[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,}$')
      AND LENGTH(TRIM(name)) BETWEEN 2 AND 50
) AS clean_data
WHERE email NOT LIKE '%@%.com';
上述代码首先在内层子查询中对`name`进行去空处理,并利用正则表达式验证邮箱格式是否符合标准模式。只有同时满足非空、长度限制及格式校验的行才会被传递到外层。外层进一步排除了特定后缀的异常邮箱,最终输出完全合规的用户列表。
如何利用窗口函数拆分并合并重复脏数据
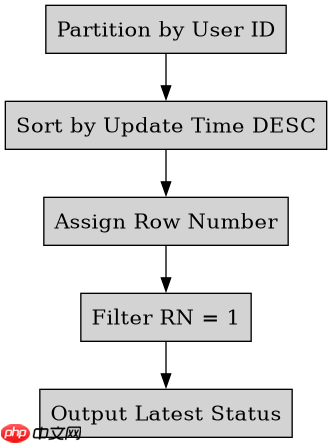
当脏数据表现为同一实体的多条冗余记录时,使用`ROW_NUMBER()`窗口函数按业务主键排序并标记优先级,是拆分和合并数据的最佳实践。内层子查询为每条记录分配序号,外层仅选取序号为1的记录,从而实现去重。
SELECT user_id, latest_status, update_time
FROM (
    SELECT
        user_id,
        status AS latest_status,
        updated_at AS update_time,
        ROW_NUMBER() OVER (PARTITION BY user_id ORDER BY updated_at DESC) as rn
    FROM order_history
    WHERE status IN ('completed', 'shipped', 'pending')
) AS ranked_orders
WHERE rn = 1;
该方案针对订单历史表中的状态变更日志,内层查询根据`user_id`分组,并按更新时间降序排列。`ROW_NUMBER()`函数为每个用户的最新状态分配序号1。外层查询通过`WHERE rn = 1`筛选出每个用户最新的业务状态,有效避免了因脏数据重复插入导致的统计偏差。
基于清洗后结果的具体问题:如何处理清洗过程中的空值填充
在多层子查询结构中,若内层清洗导致某些必要字段变为NULL,应在最外层查询中使用`COALESCE`或`CASE WHEN`进行默认值回填,确保下游应用不会因空值报错。例如,对于缺失的地区信息,可直接赋予‘Unknown’或根据城市ID映射默认区域。

















