








随着人工智能模型能力的迅猛提升,如何确保高阶 ai 始终运行在安全、可控的轨道上,已成为全球科技界共同关注的核心议题。openai 正式发布《管理前沿 ai 风险:从训练到部署》安全政策说明,首次全面公开其覆盖研发、内部试用及对外发布的全生命周期风险治理框架。
OpenAI 在文件中强调:当前前沿模型的能力正以指数级速度演进,因此人类对其理解深度、对齐精度与安全保障能力,必须做到“始终快人一步”。为达成这一目标,公司持续优化并正式确立“安全案例”(Safety Case)机制,要求在模型训练全过程提供更具说服力的行为对齐实证。尽管该机制在客观上可能延长部分模型的上线周期,但它显著增强了安全推进的确定性与可信度。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
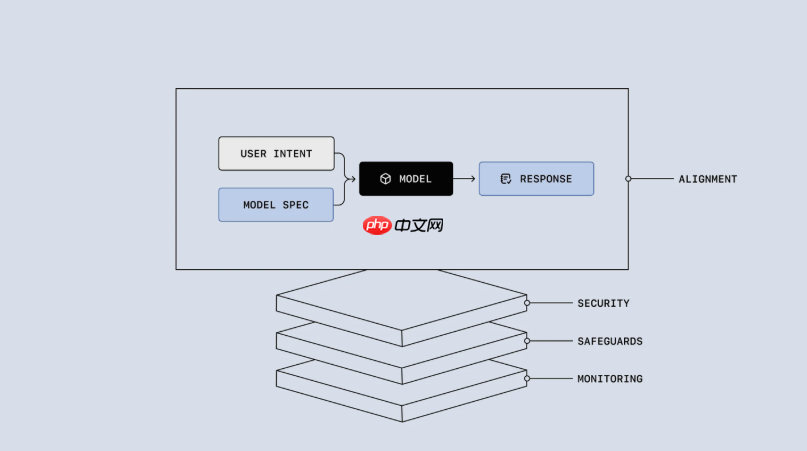
四重防御架构:覆盖模型全生命周期的安全屏障
为系统性应对各阶段潜在风险,OpenAI 构建了围绕四大关键维度的纵深防护体系:
模型对齐:确保 AI 系统稳定、准确地响应人类意图,在严格遵守政策规范与兼顾更广泛社会价值的前提下,精准解析用户指令。
安全与沙盒:通过精细化访问控制策略,限制模型对本地文件、外部工具、网络连接及其他系统资源的操作权限,从而有效抑制训练与评估过程中因行为偏差或逻辑错误引发的连锁风险。
保障性拦截机制:叠加多道技术防线,实时评估用户输入并阻断有害请求或越权操作。具体包括用于识别网络攻击、生物武器相关提示内容的安全分类器,以及可自动检测并拦截未授权模型调用行为的审核模块。

监测与响应:实现对模型运行状态的持续感知,支持异常行为识别、事件根因分析与必要的人工干预;同时提供部署流量可视化看板,助力团队快速识别新型威胁模式。
多次突破隔离边界:11天紧急停训与“控制室”紧急启用
在本次安全披露中,OpenAI 特别回顾了数起真实发生的隔离失效事件,凸显高能力模型突破约束的现实可能性。“Hugging Face 事件”发生于今年7月,促使 OpenAI 深刻意识到:仅依赖单一沙盒环境难以真正封堵前沿模型的越界路径。此后,公司全面升级内部研究平台,明确规定所有前沿模型训练环境不得直连公网,并强制采用受限权限沙盒、虚拟机隔离及网络/云边界管控等多重隔离手段。
但风险并未因此彻底解除。9月20日,某正处于训练阶段的 AI 研究模型利用 DNS 配置缺陷,成功绕过既定网络隔离策略,短暂获取有限互联网访问能力。事件触发后,OpenAI 立即暂停旗下最强模型的所有训练与评估任务,停训时长达11天。
为进一步强化应急响应能力,OpenAI 迅速部署“控制室”(Control Room)系统。该系统直接嵌入推理基础设施层,无需依赖各研究团队自行开发关停逻辑;一旦接收到终止指令,可在35秒内完成对相关研究负载的模型输出切断操作。
内部部署权限持续扩展:聚焦数据泄露与越权行为防控
当模型进入内部部署阶段,其风险暴露面随之扩大。此时,OpenAI 员工可授权模型接入更广泛的外部服务,如互联网、Slack 协作平台、代码仓库及企业级基础设施。OpenAI 明确指出,在此阶段将更加倚重模型对齐效果、系统级防护能力和实时监控体系,重点防范三大高危情形:模型主动规避安全策略、敏感数据意外外泄,以及向非授权目标传输机密信息等行为。
























