








openai于11月18日披露模型辅助芯片设计进展,称jalapeño向量单元和矩阵单元的标准单元面积分别减少约13%和10%,并介绍与amd合作验证的ppa改进。上述数字针对特定模块和设计指标,不是整颗芯片面积减少同样比例,也不能直接理解为终端应用性能提升。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
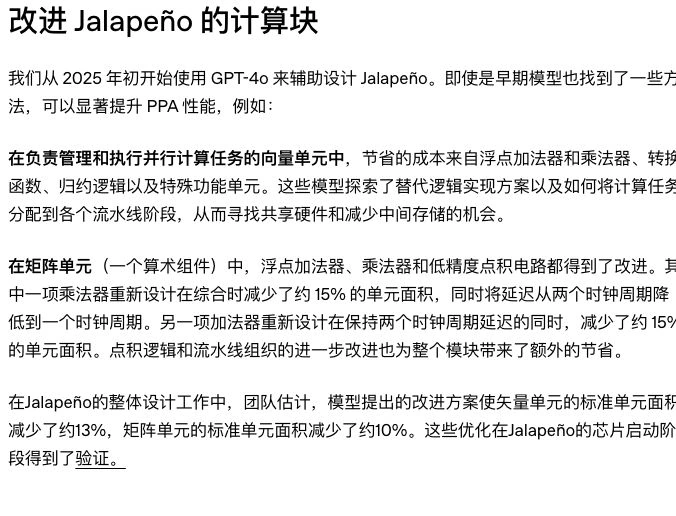
原文区分算术组件改进与整个向量、矩阵单元的面积估计。
逻辑重写改变面积与流水安排
公司介绍的方向包括浮点加法器、乘法器、转换、归约和特殊功能单元的逻辑实现,以及流水阶段之间的工作分配。一个乘法器方案在综合时减少约15%单元面积,并改变延迟周期;另一个加法器方案是在维持延迟的情况下缩小面积。它们不是同一组件的统一收益,也不能把综合面积当作最终整芯片物理尺寸。

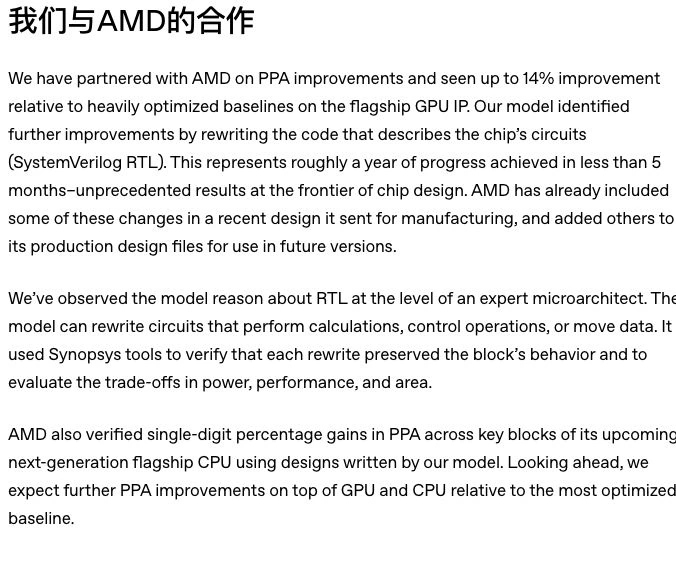
AMD相关数字为特定IP相对已有优化基线的PPA结果。
AMD已采用部分变化,仍有适用范围
OpenAI称,在旗舰GPU IP上相对高度优化的基线看到最高14%的PPA改进,部分变化已进入近期送制造的设计,另一些进入后续设计文件;CPU关键模块也有个位数百分比的PPA收益。PPA涉及功耗、性能、面积之间的权衡,不能将最高值写成GPU帧率提升14%。功能保持与收益判断仍依赖验证和EDA工具,而不是模型给出RTL后即可直接投产。
























