








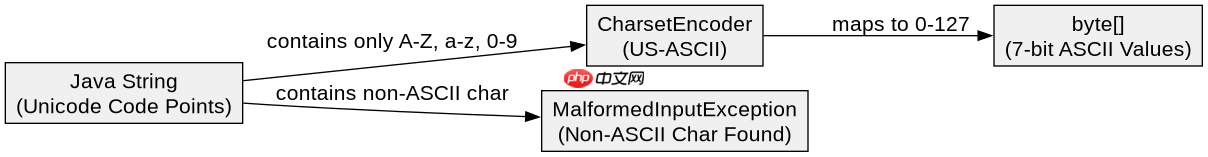
java 中处理英文数据使用 ascii 编码,最直接的方式是调用 string.getbytes("us-ascii") 获取字节数组,或使用 new string(bytes, "us-ascii") 将字节还原为字符串。由于 ascii 是 utf-8 的子集且完全兼容 latin-1,对于纯英文字符,这种转换是安全且无损的。如果输入包含非 ascii 字符,解码器会抛出 malformedinputexception,确保数据的严格性。
如何将字符串转换为 ASCII 字节数组
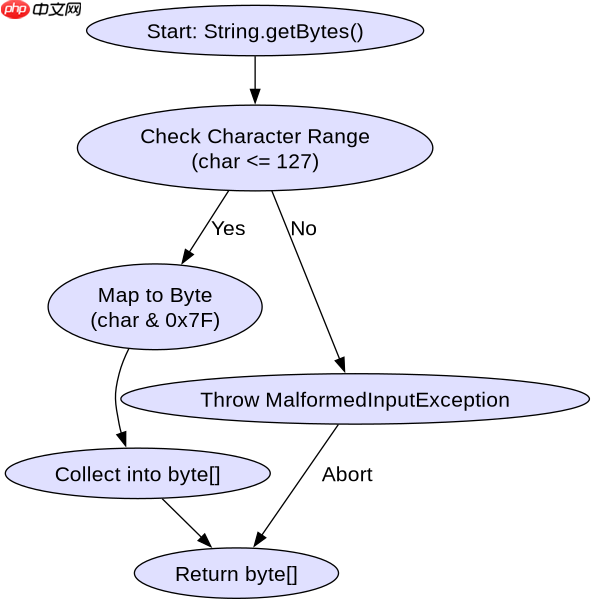
要将 Java 中的 String 对象转换为符合 ASCII 标准的字节序列,应使用 getBytes(Charset) 方法并指定 StandardCharsets.US_ASCII。此操作会将每个字符映射为其对应的 7 位 ASCII 码值。若字符串中包含超出 ASCII 范围(即大于 127)的字符,该方法在默认行为下会立即抛出 MalformedInputException,从而防止静默替换或数据损坏。这种方式适合需要严格校验输入仅包含英文字母、数字及基本符号的场景。
import java.nio.charset.StandardCharsets;
import java.nio.charset.Charset;

public class AsciiConverter {
    public static void main(String[] args) {
        String input = "Hello World";
        // 显式指定 US-ASCII 编码进行转换
        byte[] asciiBytes = input.getBytes(StandardCharsets.US_ASCII);

        System.out.println("Original: " + input);
        System.out.println("Bytes: " + bytesToHex(asciiBytes));
        System.out.println("Length: " + asciiBytes.length);
    }

    private static String bytesToHex(byte[] bytes) {
        StringBuilder sb = new StringBuilder();
        for (byte b : bytes) {
            sb.append(String.format("%02X ", b));
        }
        return sb.toString();
    }
}
如何将 ASCII 字节数组还原为字符串
将字节数组还原为可读字符串时,需使用 new String(byte[], Charset) 构造函数并传入 StandardCharsets.US_ASCII。该过程会将每个字节解释为对应的 ASCII 字符。如果字节数组中包含负值(即最高位为 1 的字节),在严格的 US-ASCII 解码下,这通常被视为无效输入。然而,String 构造函数在遇到无法映射的字节时,默认行为是用 Unicode 替代字符 \uFFFD 填充,除非配置了更严格的解码器。对于纯英文数据,这一步骤能完美还原原始文本。

立即学习“Java免费学习笔记(深入)”;

import java.nio.charset.StandardCharsets;

public class AsciiReverter {
    public static void main(String[] args) {
        // 模拟 ASCII 字节:'A' is 65, 'B' is 66
        byte[] asciiBytes = {65, 66, 67};

        // 使用 US-ASCII 解码
        String result = new String(asciiBytes, StandardCharsets.US_ASCII);

        System.out.println("Decoded String: " + result);
        // 输出: ABC
    }
}
当输入包含非 ASCII 字符时会发生什么
如果在尝试使用 getBytes("US-ASCII") 转换包含中文或非拉丁字符的字符串时,程序会抛出 MalformedInputException。这是因为 US-ASCII 编码不支持这些字符,且默认编码器策略不允许替换。开发者可以通过捕获此异常来检测非法输入,或者改用 CharsetEncoder 并设置 CodingErrorAction.IGNORE 或 REPLACE 来处理混合内容。但在纯英文数据处理场景中,这种异常机制实际上是一种保护,确保数据不会意外被截断或错误编码。


















