








java 单元测试使用分布式执行扩展能力,核心在于将本地测试任务提交给远程集群(如 junit platform launcher 结合 ci/cd 插件或专用调度器)并行运行。具体做法是配置测试发现机制以识别所有测试用例,通过 http 或消息队列将分片任务下发至多个工作节点,各节点独立执行并回传结果,最终由协调节点汇总报告。这样做能显著缩短大型项目的构建时间,但需确保测试间无共享状态依赖。
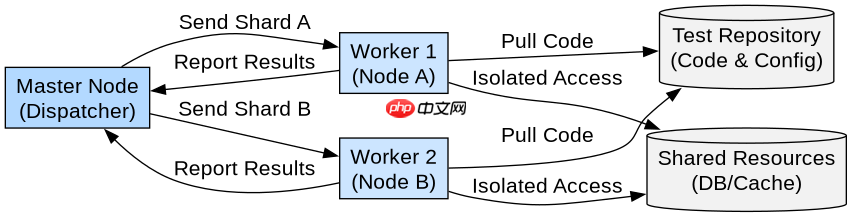
如何配置测试发现与任务分片
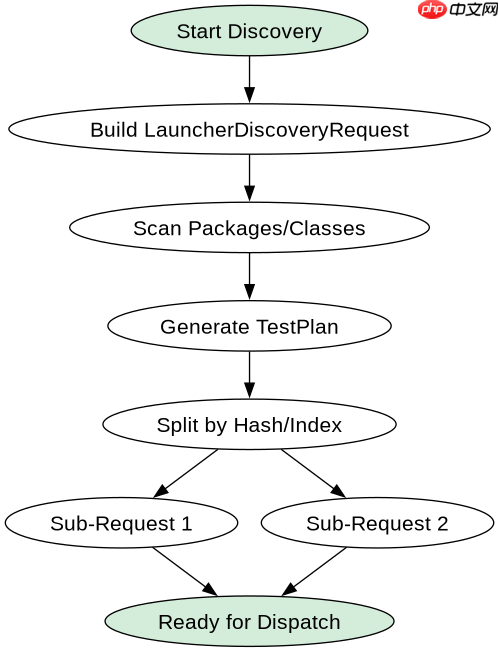
要实现分布式执行,第一步是让主节点能够准确发现所有测试类和方法,并将其划分为可独立执行的单元。通常利用 JUnit Platform 的 TestEngine SPI 接口,或者在 Maven/Gradle 中通过插件参数指定测试范围。例如,在 Maven 中使用 maven-surefire-plugin 时,可以通过 forkCount 和 reuseForks 控制本地并发,而真正的分布式往往需要结合 failsafe 或第三方工具如 Jenkins Pipeline 的分段执行。关键在于将测试集按模块、包或随机种子进行切分,确保每个子集包含完整的上下文加载逻辑。
import org.junit.platform.launcher.Launcher;
import org.junit.platform.launcher.LauncherDiscoveryRequest;
import org.junit.platform.launcher.core.LauncherDiscoveryRequestBuilder;
import org.junit.platform.launcher.core.LauncherFactory;

public class DistributedTestSharder {
    public static void main(String[] args) {
        // 1. 构建发现请求,扫描特定包路径
        LauncherDiscoveryRequest request = LauncherDiscoveryRequestBuilder.request()
                .selectors(org.junit.platform.engine.discovery.PackageSelector.packageName("com.example.tests"))
                .build();

        // 2. 获取测试计划,模拟分片逻辑
        Launcher launcher = LauncherFactory.create();
        // 实际分布式场景中,这里会将 testPlan 拆分为多个 sub-requests
        // 每个 sub-request 发送给不同的 worker node
        System.out.println("Total tests discovered: " + launcher.discover(request).getTests().size());
    }
}
上述代码展示了基于 JUnit Platform 的基础发现流程。在实际分布式架构中,Launcher 不会直接执行,而是提取测试 ID 列表。开发者需要将这个列表根据节点数量进行哈希分片,比如将测试 ID 的哈希值模 N 分配给第 N 个节点。这样每个节点只处理属于自己的那部分测试,避免了重复执行。同时,必须保证每个节点都能独立加载应用上下文,否则会出现因缺少 Bean 定义导致的启动失败。
立即学习“Java免费学习笔记(深入)”;

如何集成 CI/CD 管道实现自动分发
将单元测试接入 CI/CD 管道是实现真正分布式执行的关键步骤。主流方案是利用 Jenkins、GitLab CI 或 GitHub Actions 的矩阵构建(Matrix Build)功能。通过在流水线脚本中定义变量矩阵,如 SHARD_INDEX 和 TOTAL_SHARDS,可以在每次运行时动态生成多个并行作业。每个作业携带特定的环境变量,传递给测试执行器以过滤出对应的测试子集。这种方式无需修改核心测试代码,只需调整构建脚本即可实现水平扩展。

// Jenkinsfile 示例片段
pipeline {
    agent none
    stages {
        stage('Run Tests') {
            steps {
                script {
                    def shards = 4
                    parallel(shards.collectEntries { i ->
                        ["shard-${i}"] {
                            env.SHARD_INDEX = i
                            env.TOTAL_SHARDS = shards
                            sh 'mvn test -Dtest.shard.index=${SHARD_INDEX} -Dtest.shard.total=${TOTAL_SHARDS}'
                        }
                    })
                }
            }
        }
    }
}
在这个 Jenkins 示例中,parallel 块启动了四个并行的阶段。每个阶段设置不同的 SHARD_INDEX。测试框架需要在启动时读取这些系统属性,并根据索引过滤测试用例。例如,可以使用 JUnit 的 @Tag 或自定义注解来标记测试,或者在 BeforeAll 回调中检查当前进程是否属于该分片。如果测试依赖于数据库或外部服务,务必在每个并行阶段初始化独立的连接池或事务隔离级别,防止数据竞争导致测试不稳定。
当测试涉及共享数据库连接池时会发生什么
在分布式执行环境下,如果多个测试节点共享同一个物理数据库实例且未正确隔离事务,会导致严重的竞态条件和数据污染。具体表现为:一个节点的插入操作可能被另一个节点的查询立即看到,或者由于连接池耗尽导致超时异常。为了解决这个问题,必须在每个测试节点内部维护独立的连接池实例,并在测试开始前清空或重置相关表数据。此外,应使用事务性测试策略,即在每个测试方法结束后回滚更改,而不是依赖物理删除。
以 Spring Boot 项目为例,若使用 HikariCP 作为连接池,分布式节点会各自创建新的 HikariConfig 对象。如果配置文件中硬编码了相同的 JDBC URL 且未启用模式切换,不同节点的操作会相互干扰。正确的做法是在测试配置类中,根据环境变量动态调整数据源前缀,或者使用内存数据库如 H2 的独立模式。对于必须使用真实 DB 的场景,建议引入 Testcontainers,为每个测试容器启动一个独立的 PostgreSQL 或 MySQL 实例,从而彻底消除共享状态风险。



















