








在标准sql中,sum(1)与count(1)的执行消耗通常没有本质区别,因为两者都只涉及对行数的计数或常量的累加,优化器往往将其转化为相同的执行计划。具体做法是依赖数据库的查询优化器,它会将常量表达式识别为无需读取实际列数据的操作,从而直接统计行数。若发现消耗不同,通常是因特定数据库版本、统计信息缺失或使用了非标准的聚合逻辑导致。
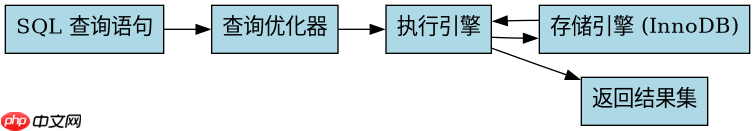
COUNT(1)在MySQL中的执行计划是怎样的
COUNT(1)在MySQL中会触发全表扫描或索引扫描以统计行数,优化器会忽略列值检查,直接计算符合条件的记录数。具体实现上,MySQL的InnoDB引擎通过聚簇索引遍历来快速获得行数,若存在WHERE条件则需过滤后计数。这样做得到的结果是准确的行数统计,且不会因NULL值而跳过记录。
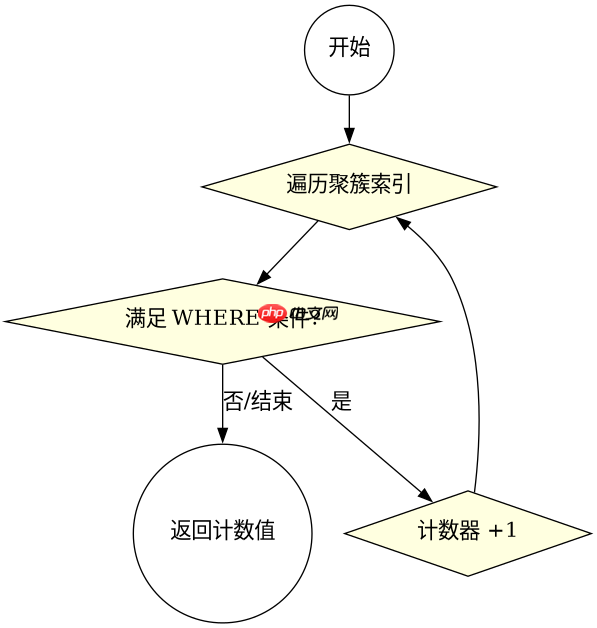
-- 假设有一个表 users(id, name)
-- 使用 COUNT(1) 统计总行数
SELECT COUNT(1) FROM users;

-- 预期结果:返回一个整数,表示 users 表的总行数
SUM(1)在MySQL中的执行计划是怎样的
SUM(1)在MySQL中同样会触发全表扫描或索引扫描,但它在每一行上将常量1进行累加,最终结果等于行数。优化器可能会将其优化为与COUNT(*)类似的内部计数器操作,因为累加常数1等同于计数。若未发生优化,其CPU开销略高于COUNT(1),因为需要执行加法运算而非单纯计数。
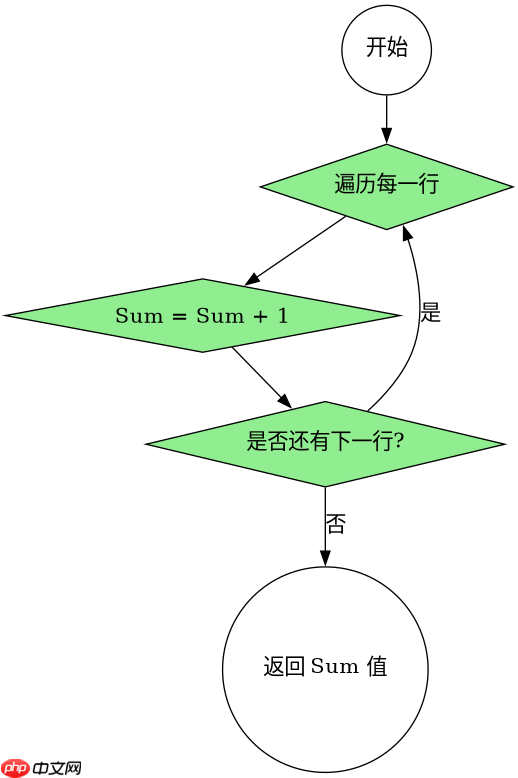
-- 使用 SUM(1) 统计总行数
SELECT SUM(1) FROM users;

-- 预期结果:返回一个整数,数值上与 COUNT(1) 相同
当表中存在NULL值时COUNT(1)与SUM(1)的结果是否一致
当表中存在NULL值时,COUNT(1)与SUM(1)的结果依然一致,因为两者都不受列值是否为NULL的影响。COUNT(1)统计的是行数而非列值,SUM(1)累加的是常量1而非列值,因此NULL值不会改变它们的计算逻辑。这一行为确保了在复杂查询中,只要WHERE条件相同,两者的输出必然相等。
















