








tree shaking 默认无法处理 css 文件,因为 css 没有 es module 的静态导入导出结构。要解决这个问题,需要引入专门处理样式的 loader(如 css-loader)和 plugin(如 minicssextractplugin),并确保在构建工具(以 webpack 为例)中正确配置,将 css 提取为独立文件并配合 purgecss 等插件进行未使用样式的删除。

Webpack 如何配置 CSS 加载与提取
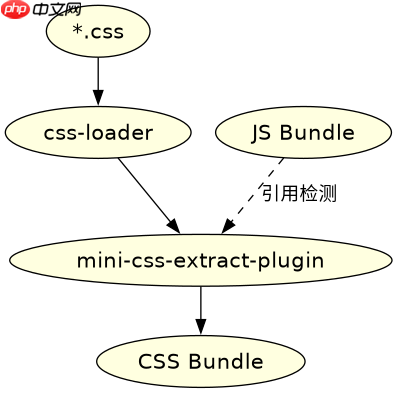
在 Webpack 项目中,处理 CSS 的核心在于 loader 链的配置。我们需要安装 css-loader 来解析 @import 和 url(),以及 style-loader 或 mini-css-extract-plugin 来处理最终输出。为了生产环境的 Tree Shaking,通常推荐使用 mini-css-extract-plugin 将 CSS 提取到单独的文件中,而不是注入到 JS 中。
{
  module: {
    rules: [
      {
        test: /\.css$/,
        use: [
          'mini-css-extract-plugin.loader',
          'css-loader'
        ]
      }
    ]
  },
  plugins: [
    new MiniCssExtractPlugin({
      filename: '[name].[contenthash].css'
    })
  ]
}
上述配置确保了所有 .css 文件被正确解析并提取。当代码中存在对 CSS 模块的引用时,Webpack 会将其纳入依赖图。如果后续引入了 PurgeCSS 插件,它会根据 JS 中的类名选择器来过滤这些提取出的 CSS 文件。
立即学习“Java免费学习笔记(深入)”;

PurgeCSS 如何集成以实现样式 Tree Shaking
仅提取 CSS 并不等于 Tree Shaking,还需要删除未使用的样式。PurgeCSS 是业界标准的解决方案,它能扫描 HTML、JS 等源文件,找出实际使用的类名,然后从最终的 CSS 文件中移除未引用的部分。在 Webpack 中,可以通过 purgecss-webpack-plugin 集成。

{
  plugins: [
    new MiniCssExtractPlugin(),
    new PurgeCSSPlugin({
      paths: glob.sync([path.join(__dirname, '*.html'), path.join(__dirname, 'src/**/*.js')]),
      extractors: [{
        extractor: class TailwindExtractor { static extract(content) { return content.match(/[A-Za-z0-9_-:/]+/g) || []; } },
        extensions: ['html']
      }]
    })
  ]
}
这个插件会在构建过程中分析指定的路径,识别出代码中实际调用的类名。例如,如果 JS 中只使用了 .btn-primary,而 CSS 中有 .btn-secondary,后者将被剔除。这实现了真正的 CSS Tree Shaking,显著减小了最终打包文件的体积。
动态生成的类名会导致什么结果
当 CSS 类名是通过 JavaScript 动态拼接或随机生成时,PurgeCSS 等静态分析工具无法在源码中找到对应的字符串匹配,导致这些样式被错误地删除。这是 CSS Tree Shaking 中最常见的陷阱之一。
// 动态类名示例
const className = `user-${userId}-active`;
document.querySelector(`.${className}`).classList.add('highlight');在上述代码中,user-${userId}-active 是运行时生成的。PurgeCSS 扫描源码时找不到完整的类名字符串,因此不会保留相关的 CSS 规则。解决此问题的方法包括:使用固定的类名前缀并在 PurgeCSS 配置中使用正则表达式白名单,或者在 CSS 文件中添加特定的注释标记(如 /* purgecss start ignore */)来排除特定规则。对于完全动态的场景,建议不要对该部分样式启用严格的 Tree Shaking,或者采用 CSS Modules 结合固定命名策略来规避风险。





















