








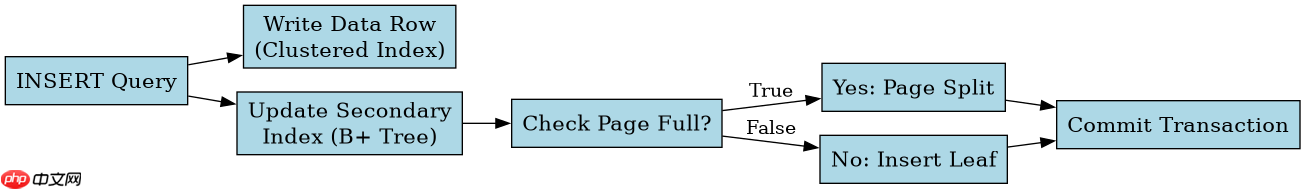
在sql中执行insert带有索引的表会变慢,是因为数据库不仅要写入数据行,还要同步更新所有相关的二级索引结构。每次插入都会触发b+树节点的查找、分裂和页合并操作,这些额外的i/o和cpu开销直接拖慢了写入速度。
为什么二级索引会增加写入开销
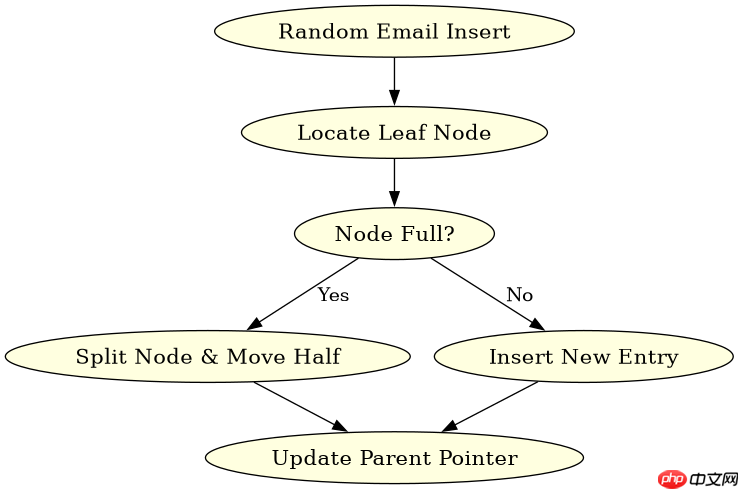
二级索引的增加主要源于B+树的维护成本。当主键是聚簇索引时,数据行按顺序存储,但二级索引需要单独维护一个映射关系。插入新数据时,数据库必须定位到对应的叶子节点,如果该节点已满,还需要进行页分裂(Page Split),这涉及大量数据移动和日志记录。
CREATE TABLE users (
    id INT PRIMARY KEY,
    email VARCHAR(255),
    INDEX idx_email (email)
);

-- 模拟高并发插入
INSERT INTO users (id, email) VALUES (1, 'user1@example.com');
INSERT INTO users (id, email) VALUES (2, 'user2@example.com');
预期结果:`users`表中新增两行,`idx_email`索引树增加两个叶子节点条目。若邮箱值随机分布,可能导致频繁的页分裂。
如何减少索引对INSERT的影响
减少影响的方法包括批量插入、禁用唯一性检查或使用临时关闭索引。批量插入可以减少页分裂次数,因为多个数据可以一起排序后插入。禁用唯一性检查(如MySQL的`unique_checks=0`)可以避免每行都进行唯一性校验,从而提升速度。

-- MySQL示例:批量插入并优化
SET unique_checks = 0;
INSERT INTO users (id, email) VALUES
(3, 'user3@example.com'),
(4, 'user4@example.com'),
(5, 'user5@example.com');
SET unique_checks = 1;
预期结果:三行数据快速插入,`unique_checks`关闭期间跳过唯一性验证,显著降低CPU开销。恢复设置后确保数据一致性。
基于索引页分裂的具体问题
当插入的数据导致索引页满时,会发生页分裂。例如,向`idx_email`插入大量随机邮箱,B+树叶子节点频繁分裂,产生碎片化存储。这不仅增加I/O,还降低后续查询效率。解决方式是使用有序插入或调整填充因子(Fill Factor)。


















