








使用sql join清洗非结构化导入的脏数据,核心思路是建立一张结构化的“标准字典表”,将导入的脏数据通过join关联到该字典表,利用join的匹配特性提取标准化值并过滤无效记录。具体做法是将脏数据表与标准字典表进行left join,筛选出成功匹配的行以获取规范字段,同时利用where条件排除未匹配(null)的脏数据,从而实现快速的数据清洗和规范化。
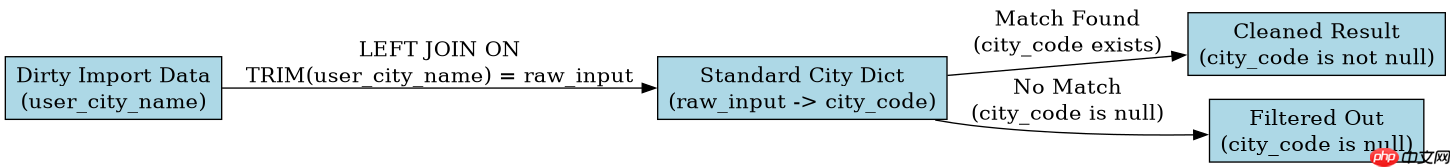
如何构建用于匹配的标准化字典表
构建标准化字典表是清洗的基础,需要确保字典表包含所有可能的合法值及其对应的规范ID或名称。通常从历史干净数据中提取唯一值,或者由业务规则定义固定枚举值,形成两列结构:原始模糊值(如去空格后的字符串)和规范值(如标准代码)。例如,创建一个名为 standard_city_dict 的表,包含 raw_input 和 city_code 字段,其中 raw_input 存储清洗后的城市名,city_code 存储对应的国家标准城市编码。
CREATE TABLE standard_city_dict (
    raw_input VARCHAR(50) PRIMARY KEY,
    city_code VARCHAR(10) NOT NULL
);

INSERT INTO standard_city_dict (raw_input, city_code) VALUES
('北京', '110000'),
('上海', '310000'),
('广州', '440100');
预期结果:表中插入了三条记录,分别对应北京、上海、广州的标准编码。此表作为后续JOIN操作的基准,确保只有存在于字典中的脏数据才能被清洗为有效记录。
如何利用LEFT JOIN实现脏数据的匹配与过滤
在拥有标准字典表后,使用LEFT JOIN将脏数据表与字典表连接。脏数据表 dirty_import_data 包含用户导入的原始城市名称 user_city_name。通过ON条件 d.user_city_name = dict.raw_input 进行匹配。对于匹配成功的行,字典表的 city_code 不为空;对于匹配失败的行(即脏数据中无法识别的值),city_code 为NULL。此时,只需在WHERE子句中过滤掉 dict.city_code IS NULL 的记录,即可保留清洗后的干净数据。
SELECT
    d.id,
    d.user_city_name,
    dict.city_code,
    d.other_info
FROM dirty_import_data d
LEFT JOIN standard_city_dict dict
    ON TRIM(d.user_city_name) = dict.raw_input
WHERE dict.city_code IS NOT NULL;
预期结果:查询返回的结果集中,所有记录的 city_code 均为有效的标准编码,且不存在因拼写错误或未知城市导致的NULL值。未匹配的记录被完全排除,实现了数据的快速过滤和规范化。
基于程序中某个输入、条件或结果的具体问题
当脏数据中存在大小写不一致或前后有空格时,直接JOIN会导致匹配失败。例如,输入值为 ' 北京 ' 或 'BEIJING',而字典表中存储的是 '北京'。此时需要在JOIN条件中使用函数处理输入值,如 TRIM(UPPER(d.user_city_name)),但需注意字典表也需预处理或使用函数索引以保持性能。若未做预处理,这些记录将被视为脏数据而被过滤掉,导致数据丢失。因此,必须在JOIN前对脏数据进行标准化预处理,确保与字典表格式一致。

















