








在sql存储过程中利用cte优化逻辑,核心做法是将复杂的嵌套查询或重复计算拆解为多个命名步骤,通过递归或链式引用提升可读性与执行效率。具体实现时,需使用with关键字定义cte,并在后续select语句中直接引用其名称,从而避免子查询带来的性能损耗和代码冗余。若涉及多层级数据(如组织架构),可启用recursive特性处理自关联表;对于普通场景,则利用cte的临时结果集特性简化join操作。

如何定义基础CTE以替代复杂子查询
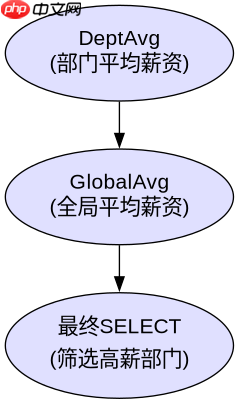
定义基础CTE的关键在于将原本写在FROM子句中的子查询提取到WITH块中,并通过别名暴露列名供外部调用。例如,当需要统计各部门员工平均薪资并筛选高于整体平均值的部门时,可将“计算整体平均值”作为第一个CTE,再基于此进行二次过滤。这种写法不仅消除了重复计算,还让逻辑流向更清晰。实际编码时,确保每个CTE只负责单一职责,避免在一个CTE中混合聚合与过滤逻辑。
WITH DeptAvg AS (
    SELECT dept_id, AVG(salary) as avg_sal
    FROM employees
    GROUP BY dept_id
),
GlobalAvg AS (
    SELECT AVG(avg_sal) as global_avg
    FROM DeptAvg
)
SELECT d.dept_name, da.avg_sal
FROM departments d
JOIN DeptAvg da ON d.id = da.dept_id
CROSS JOIN GlobalAvg ga
WHERE da.avg_sal > ga.global_avg;
上述代码中,DeptAvg先按部门聚合薪资,GlobalAvg再对部门平均值求全局均值,最终查询仅做连接与过滤。输入为employees和departments表,输出为符合条件的高薪部门列表。预期结果是返回一个包含部门名称和平均薪资的结果集,类型为标准关系表结构。
如何利用递归CTE处理层级数据
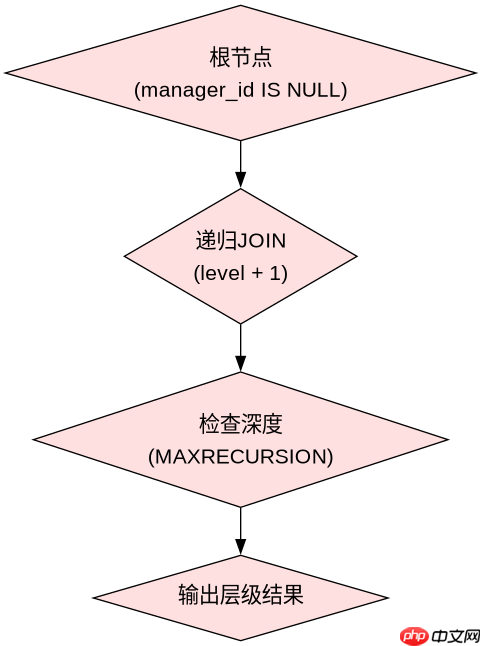
处理层级数据(如树形菜单或组织架构图)时,应使用带有UNION ALL的递归CTE。初始查询选取根节点,递归部分通过JOIN自身匹配子节点,直到无新记录为止。需注意设置最大递归深度以防无限循环,通常通过OPTION (MAXRECURSION n)控制。相比传统游标或多次迭代查询,递归CTE能一次性构建完整路径,显著减少I/O开销。
WITH OrgTree AS (
    SELECT id, name, manager_id, 0 as level
    FROM employees
    WHERE manager_id IS NULL
    UNION ALL
    SELECT e.id, e.name, e.manager_id, ot.level + 1
    FROM employees e
    JOIN OrgTree ot ON e.manager_id = ot.id
)
SELECT * FROM OrgTree OPTION (MAXRECURSION 10);
该程序从manager_id IS NULL的根员工开始,逐层向下关联下属。输入为含id, name, manager_id的employees表,输出为带层级深度的扁平化结果。预期结果中每行代表一名员工及其上级路径深度,类型为整数与字符串组合。若某分支超过10层,将触发终止条件,不会报错但会截断后续层级。
当CTE引用顺序错误时会发生什么
在存储过程中,若CTE的定义顺序与其引用顺序不一致,数据库引擎会抛出“对象名无效”错误。例如,若先写引用B的CTE,而B尚未定义,则执行失败。正确做法是严格按依赖关系排序:被引用的CTE必须出现在引用它的CTE之前。此外,同一作用域内不能重复定义同名CTE,否则也会引发语法异常。验证方法是在开发环境中故意调换顺序,观察报错信息是否指向未识别标识符。

















