








当oracle awr报告io延迟超过20毫秒时,应优先检查系统层面的i/o统计、数据库等待事件以及具体的sql执行计划。通过对比awr中的top 5 timed events和os层的iostat数据,可以快速定位是磁盘瓶颈、存储网络问题还是特定sql导致的性能下降。

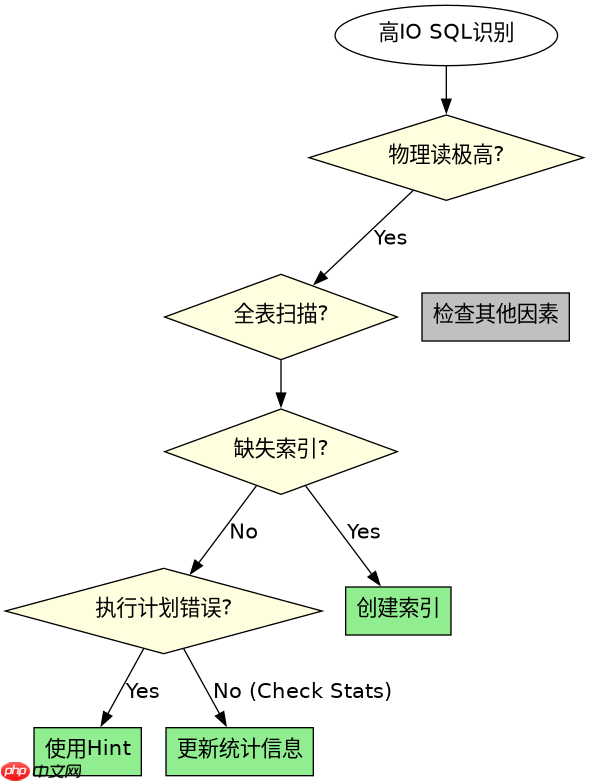
如何识别导致高IO延迟的具体SQL语句
在AWR报告中,直接查看“Top 5 Timed Events”部分,寻找以“db file scattered read”、“db file sequential read”或“log file parallel write”为主的等待事件。如果这些事件占据了大量的DB Time,说明IO瓶颈确实存在。接着,切换到“SQL Statistics”或“Top SQL”部分,按“Elapsed Time”或“Buffer Gets”排序,找出消耗资源最多的SQL。重点关注那些物理读(Physical Reads)极高但逻辑读(Buffer Gets)相对较少的SQL,这通常意味着全表扫描或索引失效导致了大量的磁盘IO操作。
SELECT sql_id, sql_text, elapsed_time, cpu_time, buffer_gets, disk_reads
FROM v$sql
WHERE last_active_time > SYSDATE - 1/24
ORDER BY disk_reads DESC;
运行上述查询可以获取当前共享池中活跃的高IO SQL。结合AWR中捕获的时间段,使用`sql_id`进一步分析其执行计划,确认是否存在缺失索引或统计信息过期的问题。

如何通过OS层工具验证存储子系统状态
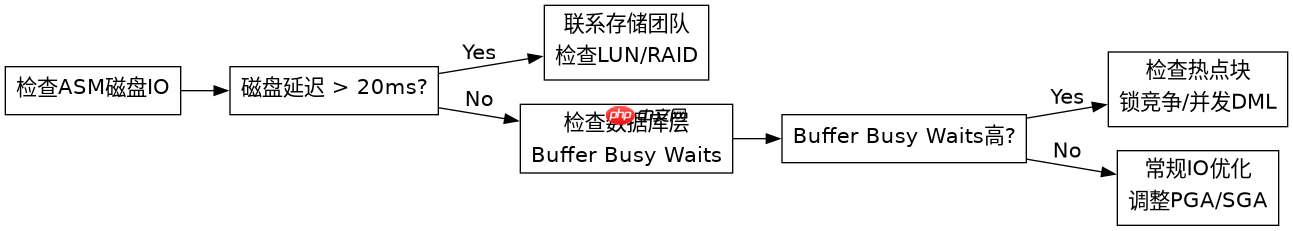
数据库层面的IO等待往往根源于操作系统或存储层。在Linux环境下,使用`iostat -x 1 10`命令监控磁盘的利用率(%util)、平均响应时间(await)和服务时间(svctim)。如果`%util`接近100%且`await`显著高于`svctim`,表明磁盘队列积压,这是造成AWR中IO延迟高的直接原因。同时,检查是否有其他进程(如备份软件、日志轮转)占用了大量带宽。对于ASM环境,还需检查`v$asm_disk_iostat`视图,确认是哪个具体磁盘组或磁盘出现了异常延迟。
SELECT name, path, read_time, write_time, read_reqs, write_reqs
FROM v$asm_disk_iostat
WHERE read_time > 20 OR write_time > 20;
该查询用于筛选出响应时间超过阈值的ASM磁盘。如果发现特定磁盘延迟高,需联系存储管理员检查底层LUN的健康状况、RAID配置或控制器缓存策略,排除硬件故障或配置不当的影响。
基于AWR中Buffer Busy Waits与Latch Free事件的关联排查
有时AWR显示的IO延迟并非纯粹的磁盘慢,而是由于数据块竞争导致的逻辑IO阻塞。如果在“Top 5 Timed Events”中看到“buffer busy waits”或“latch free”占比很高,说明高IO延迟可能是由并发访问热点块引起的。此时,单纯优化SQL可能效果有限,需要检查是否涉及全局临时表、高并发的DML操作或索引结构不合理。通过查询`v$session_wait`和`v$event_name`,可以定位到具体的文件号和块号,进而使用`dbms_utility.data_block_address_block`函数解析出对应的对象,检查该对象的锁竞争情况。




















