








在sql中找出重复数据并统计出现频次,核心做法是使用 group by 对目标列进行分组,配合聚合函数 count(*) 计算每组的行数,并通过 having count(*) > 1 过滤出频次大于1的记录。这一方法适用于任何需要识别重复项的场景,只需将 group by 后的列替换为实际业务中的唯一标识或组合键即可得到准确的频次统计结果。

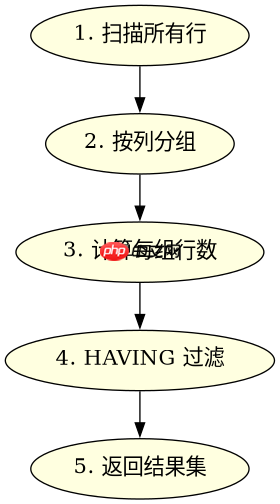
GROUP BY 与 HAVING 的执行顺序是怎样的
GROUP BY 先按指定列将数据行合并为组,随后 HAVING 子句对这些已形成的组应用筛选条件,只有满足条件的组才会被返回。这种机制确保了过滤操作作用于聚合后的统计值而非原始行数据,从而精准定位重复记录。
CREATE TABLE users (
    id INT PRIMARY KEY,
    email VARCHAR(100)
);

INSERT INTO users (id, email) VALUES
(1, 'alice@example.com'),
(2, 'bob@example.com'),
(3, 'alice@example.com'),
(4, 'charlie@example.com'),
(5, 'bob@example.com'),
(6, 'bob@example.com');
预期输出:
email             | count(*)
------------------|----------
alice@example.com | 2
bob@example.com   | 3
如何同时获取重复数据的原始ID列表
若需保留重复数据对应的原始主键ID以便进一步处理,可在查询中使用 GROUP_CONCAT(MySQL)或 STRING_AGG(PostgreSQL/SQL Server)将同组内的ID拼接为字符串。这样既能看到哪些记录重复,又能通过拼接结果直接关联到具体行,避免二次查询带来的性能损耗。

SELECT email,
       COUNT(*) AS freq,
       GROUP_CONCAT(id ORDER BY id SEPARATOR ',') AS user_ids
FROM users
GROUP BY email
HAVING COUNT(*) > 1;
预期输出:
email             | freq | user_ids
------------------|------|---------
alice@example.com | 2    | 1,3
bob@example.com   | 3    | 2,5,6
当存在多个字段组合时如何判断重复
如果重复的定义依赖于多个字段的组合(例如用户名和邮箱同时相同才算重复),只需在 GROUP BY 后列出所有相关字段即可。数据库会将这些字段的值组合视为一个唯一的分组键,只有当所有指定字段的值完全一致时,才会被归入同一组并进行频次统计。这种方法避免了单一字段可能产生的误判,确保重复逻辑符合业务定义。
















